如何優化 AI Agent:從常駐指令、Skills 到驗證方法
AI agent 明明拿到完整需求,卻反覆詢問能不能繼續;只是修改幾行文件,卻啟動一整套開發流程;裝了許多 skills,真正需要時又選不到。遇到這些情況,除了換模型,也該檢查 agent 每次工作時讀到了哪些指令。
優化可以從三個問題開始:哪些規則每次都需要?哪些知識只在特定任務需要?修改後,如何證明任務做得更好? 把這三件事分清楚,才有辦法減少無效工作,同時保留專門能力。
OpenAI 在 GPT-6 Astra 的官方指南中建議審核 skills 與 AGENTS.md:模型對指令更敏感,模糊或互相衝突的內容可能讓它提早停下來。1 以下結合多家廠商的一手文件,整理成七個可實作的步驟;範例是本文設計的通用模板,使用前應替換成自己的專案設定。
1. 從一次失敗,找出真正該改的地方
先挑一個經常出問題的任務,保存使用者要求、agent 的可見操作紀錄、工具輸出與最後結果。找到第一個偏離預期的位置,再決定要改 prompt、skill,還是工具環境。
| 觀察到的問題 | 優先檢查 | 可嘗試的修改 |
|---|---|---|
| 已有完整需求,仍反覆要求確認 | 是否有「每次都先問」的舊規則 | 寫清楚需要澄清的條件 |
| 小任務啟動完整研究或開發流程 | skill description 是否過於廣泛 | 限定觸發任務與交付物 |
| 每次重新摸索相同 API 或檔案格式 | 缺少專案知識、範例或腳本 | 把穩定步驟加入相應 skill |
| 同一指令在不同工具中表現不同 | 實際載入的檔案、版本與作用範圍 | 修正入口與同步方式 |
| 工具反覆回傳登入或連線錯誤 | 憑證、網路、依賴與權限 | 修復環境,再測原任務 |
這張表是診斷起點,不能單憑症狀認定原因。尤其工具連線失敗時,多寫一段「請努力完成任務」通常無法修復設定。
若懷疑某份 skill 讓 agent 停住,可以要求它提供可核對的依據:
若某份專案指令或 skill 導致你暫停或改變執行方向,
請列出檔案路徑與相關句子,說明該條件如何適用於目前任務。
這能協助檢查檔案與實際行為,仍要對照工具紀錄;agent 對原因的描述本身不等於因果證明。OpenAI 的指南也提供要求 agent 指出阻礙指令的做法。1
2. 把常駐規則、任務流程與參考資料分層
Context 指模型當次可讀取的內容,包含指令、對話、工具結果與文件。Context engineering 則是在安排這些內容何時進來、保留多少,以及如何讓相關資訊容易被找到。Anthropic 的官方文章強調,要在有限的注意力預算中提供有用資訊,並避免過度細碎或過度籠統的指引。2
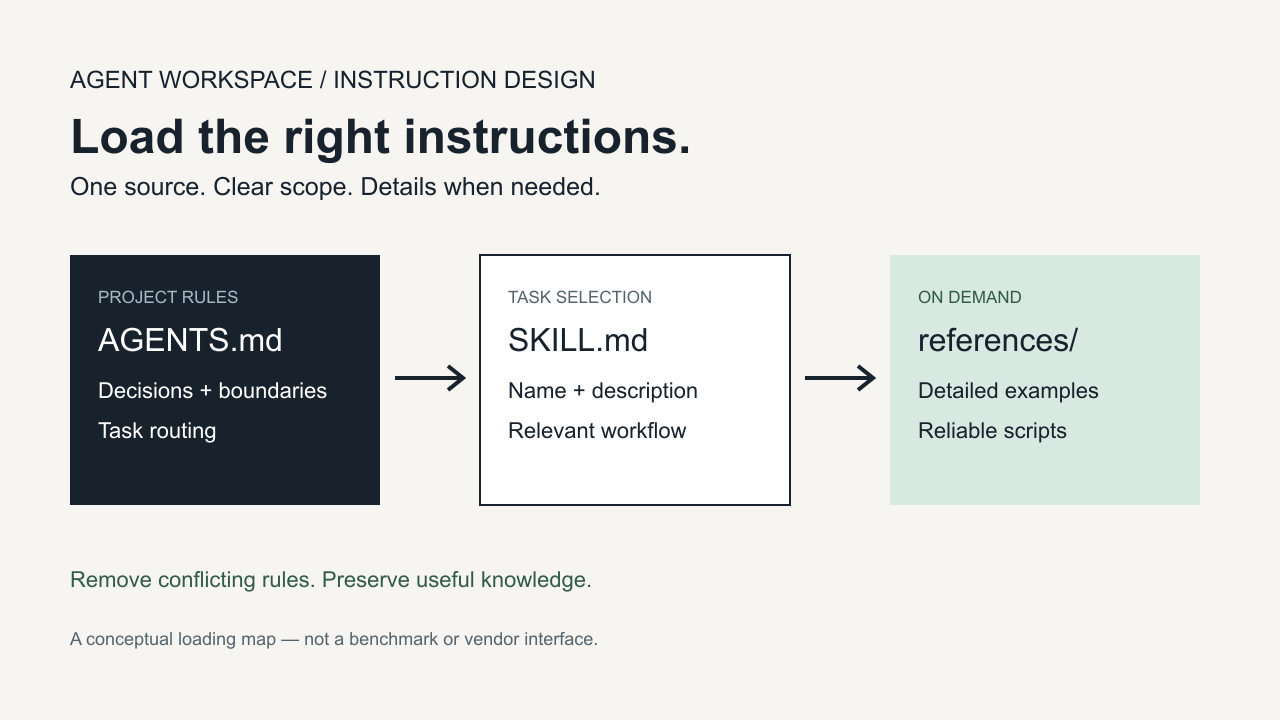
實作時,可以先把內容分成四層:
| 層次 | 適合放什麼 | 不適合放什麼 |
|---|---|---|
| 常駐指令 | 專案位置、廣泛適用的限制、重要入口 | 所有任務的完整操作手冊 |
| Skill 描述 | 什麼任務應使用它、處理什麼交付物 | 含糊的「處理任何問題」 |
| Skill 正文 | 該任務的核心流程與完成條件 | 每個 API 的所有欄位與歷史筆記 |
| 按需參考資料 | 特定分支的規格、範例、故障排除 | 沒有路由、無人知道何時該讀的文件 |
如果你使用託管的 coding agent,通常能調整的是專案指令和 skills,平台內建 system/developer 指令由產品管理。如果你自行開發 API agent,則可把廣泛適用的應用規則放在自己控制的 system/developer 訊息中。不同工具的載入方式仍須分別確認。
例如,一個小型 web 專案的 AGENTS.md 可以從這種結構開始:
# Project instructions

- 應用程式在 app/;測試與執行入口以 package.json 為準。
- 編輯前讀取目標檔案及其適用的目錄指令。
- 保留與目前任務無關的未提交修改。
- 修改後執行相關檢查,以及專案要求的必要檢查。
- 涉及資料庫 schema 時,先讀 docs/database-changes.md。
- 交付時說明結果、驗證方式與尚未驗證的部分。
這個模板假設你有相應目錄與文件;沒有就刪除或替換。專案真正特殊的限制也應補進來,例如某個目錄由生成器維護,或某項操作有固定順序。它們比「你是一位非常優秀的工程師」更能改變具體決策。
GitHub 的官方文件建議指令簡短、自足,並支援按檔案路徑限定規則。3 因此,只有資料庫目錄需要的規範,應優先放在該範圍或由相關任務讀取。
3. 改寫模糊命令,讓 agent 知道何時行動
常見的指令問題,是把某次失敗的補救措施寫成永久規則。一次需求不清楚,就加上「每次都先問」;一次測試不足,就加上「任何修改都跑全部測試」。規則累積後,每個任務都可能被迫支付相同成本。
可以把這類句子改成「條件、行動、完成判準」:
| 原指令 | 改寫範例 |
|---|---|
| 開始前一律等使用者確認 | 缺少會改變交付物或操作授權的資訊時,先詢問;已有資訊足夠時,完成目前授權範圍內的工作。 |
| 任何修改都跑所有測試 | 依改動影響選擇測試,並完成專案規定的必要檢查;失敗或出現跨模組影響時再擴大驗證。 |
| 一直重試直到成功 | 先判斷失敗原因;只有原因已改變或錯誤屬暫時性時重試,避免重複相同的失敗操作。 |
| 發現問題就自動修好 | 修正任務範圍內的問題;無關問題記錄影響與位置,避免把小任務擴張成全面重構。 |
這些改寫是可測試的候選版本。像付款、對外發訊息或正式部署,仍可能需要獨立授權;不要把「減少確認」寫成全面跳過權限判斷。專案文字也不能取代工具本身的存取控制。
對每一條常駐規則,問一句就很有用:它會讓 agent 在哪個具體情況做出不同決定? 如果答案只有「看起來比較謹慎」,應考慮刪掉空泛文字,或補上真正要防止的錯誤。
4. 先修 skill 的觸發條件,再擴寫正文
Skill 可以理解成某種任務的操作手冊,通常搭配描述、參考資料與腳本。以 OpenAI 的 skills 機制為例,agent 先看到名稱和描述,選中後才載入完整內容;同名 skills 不會自動合併。4
因此,第一個該檢查的往往是 description。下面這種描述難以幫助選擇:
name: review
description: 幫忙研究、檢查、分析與改善各種內容。
可以改成明確的任務:
name: review-api-change
description: >-
  檢查 API 變更對既有呼叫端的相容性。
  適用於使用者要求 review API diff、評估 breaking change,
  或檢查 request/response schema 修改時。
Google Gemini CLI 的官方指南同樣強調,描述應明確說明觸發條件,並避免與其他 skills 或模型一般能力重疊。5
接著用一對正反例測試它:
- 「檢查這個 PR 是否破壞舊版 API client」:應選中。
- 「把 README 的 API 範例排版整齊」:一般不需要啟動相容性審查。
正文則提供完成任務真正缺少的知識。對這個例子,可以寫成:
# Review an API change

1. 讀取 API diff、既有契約及受影響的呼叫端。
2. 對照修改前後的必填欄位、型別、狀態碼與錯誤格式。
3. 若涉及分頁,讀 references/pagination.md。
4. 為具體相容性疑慮找出呼叫端範例或相關測試證據。
5. 輸出問題位置、觸發條件、影響及建議;區分已驗證與推測。
只有專案確實採用的規格才放進 references。不要為了讓 skill 看起來完整,重寫一整本 HTTP 教科書。
5. 用按需載入減少干擾,用腳本處理固定操作
Anthropic 的 skill 撰寫指南建議將 SKILL.md 正文控制在 500 行以下,接近時拆出詳細材料。6 這是整理上的實務建議,並不是所有模型共有的硬限制,也不能保證 499 行的內容就有用。
可以採用這樣的結構:
review-api-change/
├── SKILL.md
├── references/
│   ├── pagination.md
│   └── error-format.md
└── scripts/
    └── compare_schema.py
SKILL.md 必須說明何時讀哪份參考資料。只有檔案分開,卻要求 agent 每次先讀完全部資料,仍然會把整套內容帶進 context。Claude Code 的 @path 匯入也會載入被引用的檔案;用它把長手冊全部匯入,不能期待因此降低啟動時的 context 用量。7
同樣地,所有 skills 在磁碟上的總大小,不等於一次任務實際載入的量。應分別觀察常駐指令、skill metadata、被選中的正文,以及後續讀取的參考資料與工具輸出。
固定操作則適合交給腳本,例如解析 schema、執行已知檢查或產生固定格式報表。Google 的指南建議依任務容易出錯的程度調整自由度:固定、脆弱的程序需要較具體的執行方式,開放問題則保留判斷空間。5
例如 compare_schema.py 可以負責列出移除欄位與型別變更,由 agent 判斷它們是否影響既有 client。腳本應有明確參數、失敗狀態與可讀結果;把不穩定命令搬進檔案,還不算完成優化。
6. 確認真正生效的是你改過的那份指令
多工具環境特別容易出現一個陷阱:你修改的是來源檔,agent 讀到的卻是另一份副本。
先核對目前工具會讀哪些全域、專案與子目錄指令,以及生效位置與優先順序。Codex 與 Cursor 都有 AGENTS.md 的官方說明;Claude Code 則有自己的 CLAUDE.md 與匯入機制,不能直接假設三者完全相同。897
如果需要跨工具共用規則,可以維護一份來源,再依工具建立匯入入口或生成副本。選擇重點是能驗證每個入口指向預期內容,而非目錄名稱看起來整齊。
修改後,在新對話中執行一個小任務,檢查實際讀檔與行為。舊對話可能已載入先前內容,不適合單獨拿來判定新版本是否生效。移除重複檔案前也要比較內容,避免把只存在於某份副本的專案知識一起刪除。
7. 用固定任務驗證,不用字數替效果打分數
少了幾千字,可以證明文件變短;是否更快、更準、更少卡住,需要實際任務證據。OpenAI 的 eval 指南建議採用符合真實使用情境的任務與評分方式,持續累積失敗案例,而非只憑主觀感覺判斷。10
一開始可以建立一小組自己的任務集。以下是本文建議的起點:
| 測試任務 | 主要觀察 |
|---|---|
| 修正一處文件連結 | 是否只做必要修改,沒有啟動無關流程 |
| Review 一個破壞相容性的 API diff | 是否選中對的 skill,找到具體問題 |
| 同樣提到 API,但只修改文件排版 | 是否避免誤觸完整 API 審查 |
| 執行資料庫變更的演練 | 是否讀到專用規範,保留必要檢查 |
| 準備對外訊息草稿 | 是否保持草稿,沒有自行發送 |
| 模擬工具暫時失敗與永久錯誤 | 是否區分可重試問題與需要修正的設定 |
為每個任務先寫下完成標準,再比較修改前後版本。固定模型、推理設定、工具版本、輸入和 repository 起始狀態;每次從乾淨的新對話開始。同一任務重複執行,避免把一次偶然成功當成進步;涉及外部副作用的任務,用測試環境或模擬工具驗證。
至少記錄任務是否完成、結果是否正確、是否遵守必要限制,再看執行時間、token 用量、工具呼叫、誤觸 skills 與多餘確認次數。若只能觀察部分 token,應明確標示量測範圍。
每輪先改一類問題,例如只修改觸發條件,或只調整參考資料載入;一次同時換模型、刪除半套指令並更動工具,就很難知道收益來自哪裡。
研究也提醒我們不要預設 skills 一定有益或有害。《Evaluating AGENTS.md》的 v1 在受測 coding 任務中發現,自動產生的 context files 可能降低成功率並增加成本;SkillsBench 1.1 則在其受測設定中觀察到人工整理 skills 的收益。這些結果受任務、模型與執行框架限制,不能直接換算成你的工作流效益,也不能推出通用的 skill 數量配額。1112
如果今天就要開始,挑出一個最常失敗的任務,定位第一個偏離預期的步驟,只改與它有關的指令或工具,再用相同條件重跑。當改善能穩定重現,把測試案例留在專案裡;之後每次更換模型或修改 skills,都能檢查同一個問題有沒有回來。
參考來源
官方文件於 2026-09-09 查閱。以下區分廠商指南與原始研究;正文中的模板和測試表是本文的實作建議,並非官方標準設定。
- OpenAI:Using GPT-6 Astra — Prompting best practices。
- Anthropic:Effective context engineering for AI agents。
- GitHub:About customizing GitHub Copilot responses。
- OpenAI:Build skills。
- Google Gemini CLI:Agent Skill best practices。
- Anthropic:Skill authoring best practices。
- Anthropic:How Claude remembers your project。
- OpenAI:Custom instructions with AGENTS.md。
- Cursor:Rules — AGENTS.md。
- OpenAI:Evaluation best practices。
- Gloaguen 等:Evaluating AGENTS.md v1。原始研究,2026-02-12。
- SkillsBench 團隊:SkillsBench 1.1。研究團隊發布,2026-06-16。