2026 年 4 月,Andrej Karpathy 在 GitHub 上發了一份 gist,標題只有三個字:「LLM Wiki」。沒有程式碼,沒有套件,只有一個想法。但這個想法,可能正在改寫我們對個人知識管理的基本假設。
他的核心主張很簡單:別再讓 AI 每次都從零開始找答案了。讓它幫你建一座持續成長的知識庫。
RAG 的根本問題:每次都在重新發明輪子
目前主流的 AI 知識工具——NotebookLM、ChatGPT 檔案上傳、各種 RAG 系統——運作邏輯大致相同:你丟一堆文件進去,問問題時 AI 去撈相關片段,拼湊出答案。
這叫做 Retrieval-Augmented Generation(RAG),而它有一個根本性的問題:知識永遠不會累積。
Karpathy 用一段話精準描述了這個困境:
「LLM 在每個問題上都從零開始重新發現知識。沒有任何累積。問一個需要綜合五篇文件的細微問題,LLM 每次都得重新找到並拼湊相關片段。什麼都沒有建立起來。」
這不只是理論上的問題。根據學術研究,RAG 系統在真實企業場景的準確率僅有 9-17%(arXiv:2604.02640)。即使是表現最好的 NotebookLM,仍有 13% 的幻覺率;ChatGPT 的檔案問答幻覺率更高達 40%(arXiv:2509.25498)。更糟的是,RAG 存在所謂的「歸因漂移」問題——一位參議員的個人意見,經過 RAG 處理後可能變成一個不容質疑的普遍事實。
Barnett 等人在 2024 年的研究中歸納了 RAG 的七個失敗點:遺失內容、排序失誤、上下文截斷、提取失敗、格式錯誤、精確度不足、答案不完整。每一個都源自同一個結構性缺陷:把文件切成碎片再用向量相似度拼回去,本質上就是在丟棄上下文。
LLM Wiki:從「檢索」到「編譯」
Karpathy 提出的替代方案,概念上更接近程式語言中的「編譯」而非「直譯」。
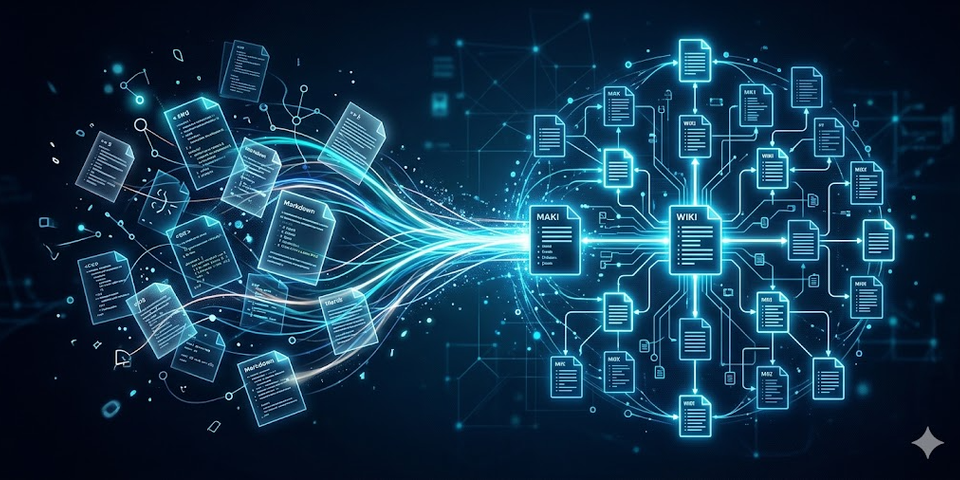
傳統 RAG 像是直譯器(interpreter):每次執行都重新解析原始碼。LLM Wiki 像是編譯器(compiler):在寫入時就把知識處理成結構化的中間產物,之後的查詢直接讀取編譯後的結果。
三層架構
整個系統分為三層:
原始資料(Raw Sources)——你收集的文章、論文、圖片、數據檔案。這一層是不可變的,LLM 只讀不寫。這是你的事實來源。
Wiki 層——由 LLM 生成並維護的 Markdown 檔案目錄。摘要頁、實體頁、概念頁、比較分析,全部帶有交叉引用和反向連結。LLM 完全擁有這一層。你讀它;LLM 寫它。
Schema 層——一份設定文件(如 Claude Code 的 CLAUDE.md),定義 Wiki 的結構、慣例和工作流程。這是把通用 AI 變成紀律嚴明的知識管家的關鍵。
Karpathy 用了一個精妙的類比:「Obsidian 是 IDE;LLM 是程式設計師;Wiki 是程式碼庫。」
三個核心操作
Ingest(攝入)——丟一份新資料進來,LLM 讀完後不只是建索引,而是把關鍵資訊整合進現有的 Wiki:更新實體頁、修訂主題摘要、標記新舊資料的矛盾之處。一份資料通常會觸動 10-15 個 Wiki 頁面。
Query(查詢)——問問題時,LLM 先讀 index.md(一份結構化的頁面目錄),找到相關頁面,再綜合出帶引用的答案。關鍵洞察:好的答案可以被存回 Wiki 成為新頁面。 你的探索本身就在增厚知識庫。
Lint(檢查)——定期讓 LLM 做健康檢查:找矛盾、標記過時主張、發現孤立頁面、補上缺失的交叉引用。這相當於知識庫的程式碼審查。
從 Memex 到 LLM Wiki:80 年的知識管理演進
Karpathy 在 gist 中明確提到了 Vannevar Bush 1945 年的 Memex 概念。這不是隨意的引用——LLM Wiki 確實是 Memex 願景在 80 年後的技術實現。
1945 年,Bush 在《As We May Think》中構想了一台桌面大小的機器,能儲存個人資訊並透過「聯想路徑」(associative trails)串聯文件。他的洞察是:人類思維是聯想式的,而不是層級分類式的。但他無法解決的問題是:誰來做維護?
之後的 80 年,每一代知識管理工具都試圖回答這個問題:
| 年代 | 工具/方法 | 關鍵創新 | 未解決的問題 |
|---|---|---|---|
| 1945 | Memex (Bush) | 聯想式連結,而非層級分類 | 從未被製造出來 |
| 1950s | Zettelkasten (Luhmann) | 原子化筆記 + 浮現式結構 | 需要數十年的手動維護(Luhmann 累積了 9 萬張卡片) |
| 1965 | 超文本 (Nelson) | 非線性連結文本 | Project Xanadu 從未完成 |
| 1995 | WikiWikiWeb (Cunningham) | 任何人都能編輯和連結 | 維護成本隨規模爆炸性增長 |
| 2017 | Second Brain (Forte) | 方法論標準化(CODE/PARA) | 仍需大量手動整理,50 萬讀者中多數中途放棄 |
| 2020 | Obsidian / Roam | 雙向連結 + 本地 Markdown | 建立連結仍是手動的 |
| 2026 | LLM Wiki (Karpathy) | LLM 負責所有維護工作 | 規模上限、幻覺累積(見下文) |
每一代都在降低知識管理的「摩擦」,但從未消除「維護成本」這個根本瓶頸。LLM Wiki 的突破在於:它第一次把維護成本降到接近零。
正如 Karpathy 所說:「人類之所以放棄維護 Wiki,是因為維護負擔的增長速度超過了價值的增長速度。LLM 不會無聊,不會忘記更新交叉引用,而且能一次性修改 15 個檔案。」
社群實作:從想法到工具生態
Karpathy 的 gist 有一個刻意的設計:他分享的是想法,不是程式碼。因為在 Agent 時代,描述一個模式比發布一個固定的 GitHub repo 更有價值——每個人的 LLM 代理會根據自己的需求客製化實作。
但社群還是迅速建起了一套工具生態:
qmd(Shopify CEO Tobi Lutke 開發)——一個本地端的 Markdown 搜尋引擎,結合 BM25 關鍵字搜尋、向量語意搜尋和 LLM 重排序,全部在裝置上執行。GitHub 19,700 顆星。它不是 Wiki 建構器,而是 LLM Wiki 的搜尋層——當 Wiki 規模超過 index.md 能處理的範圍時,qmd 接手。
sage-wiki——用 Go 寫的 LLM Wiki 編譯器,Karpathy 發文後一天內就出現。五階段漸進式處理管線(diff、summarize、extract、write、images),嚴格的型別化實體系統防止概念重複。基準測試顯示關鍵字搜尋延遲僅 411 微秒,圖譜走訪只要 1 微秒。
openaugi——把 Obsidian vault 轉換成 SQLite 知識圖譜,透過 MCP 暴露給 Claude。支援雙向操作:Agent 不只能讀,還能寫回 vault。開發者的哲學:「write-back 是知識複利的關鍵。」
LLM Wiki v2(rohitg00)——對 Karpathy 原始設計最有深度的延伸。加入了信心分數(每個事實都有可信度標籤)、知識衰減(基於 Ebbinghaus 遺忘曲線的保留機制)、四層記憶整合(工作記憶 → 情節記憶 → 語義記憶 → 程序記憶),以及多 Agent 同步。他對 v1 的核心批評:「把所有 Wiki 內容視為永遠同等有效。」
與現有工具的比較:沒有人在做「知識編譯」
把 LLM Wiki 放在現有 AI 知識工具的光譜上看,它佔據了一個獨特的位置。
NotebookLM——Google 的旗艦產品,免費且體驗出色。但它本質上是精緻版 RAG:每次對話都從你上傳的文件重新檢索,沒有持久的知識綜合。Audio Overviews(Podcast 風格摘要)是殺手功能,但知識不會跨 session 累積。
Notion AI——工作區層級的 AI 搜尋,整合 Slack 和 Google Drive,多模型支援(GPT-5、Claude Opus 4.1、o3)。協作能力最強,但 AI 是附加功能,不是核心架構。它回答問題,但不會自主建構知識圖譜。
Mem.ai——最接近自動化組織的工具(自動連結、時序脈絡),但仍然是檢索導向。它連結筆記,但不會把它們編譯成綜合知識。
Khoj——開源、可自架,支援多種 LLM,GitHub 17,000 顆星。但底層仍是 RAG 檢索。
關鍵觀察:目前市面上沒有任何工具在做 Karpathy 所說的「知識編譯」。 所有商業工具都停留在「讓 AI 幫你搜尋」,而非「讓 AI 幫你建構理解」。
一位 Hacker News 使用者精準地點出了這個差異:「向量資料庫只對機器有用。你打不開一個 .faiss 檔案來瀏覽它。但 Wiki 對人和機器都有用。」
誠實面對限制
LLM Wiki 不是萬靈丹。在 Hacker News 的討論中和實際使用者的回報中,幾個真實的問題浮現了:
規模上限。index.md 在 100-200 頁時開始撐不住——檔案本身超過了模型的上下文窗口。雖然模型標稱支援 200K token,但研究顯示品質在 130K token 左右就開始衰退(「lost-in-the-middle」現象)。Karpathy 自己的 Wiki(約 400K 字 / 530K token)已經超出單次模型讀取的可靠範圍。
幻覺會被永久嵌入。當 LLM 生成的內容建立在 LLM 生成的內容之上,錯誤會被「編譯」進知識庫。一位 HN 評論者引用了 Nature 上關於「模型崩潰」的論文,警告這種做法會邀請退化——「所謂的複利效果,可能只是不斷把有效資訊改寫成品質更差的資訊。」
成本不低。一位使用者回報,編譯三本書(155K 字)消耗了約 1200 萬 token。以 Sonnet 4.6 的費率估算,約 200。而且 Anthropic 在 200K token 門檻處有階梯式加價——199K token 的請求花 1.21。
學習本身的損失。這或許是最深層的批評。一位 HN 使用者寫道:「寫文件的過程本身就在更新你自己的心智模型。」另一位引用了 Ezra Klein 的話:「如果你沒有什麼屬於人類的話要說,那就別說。」把所有知識整理工作外包給 AI,你省下的可能正是你最需要的認知過程。
不適合企業。沒有權限控制、沒有合規等級的審計追蹤、整個知識庫就是一堆純文字檔案。Epsilla 的企業分析直言這個檔案系統實作對企業來說「危險地天真」。
更大的圖景:從記帳員到策展人
LLM Wiki 的意義超越了一個工具或一個方法論。它代表了知識工作的一次根本性轉變。
Tiago Forte——「Building a Second Brain」的作者、個人知識管理領域最有影響力的思想家之一——在 2023 年初就停止了 BASB 課程的教學,因為他認為自己的方法「突然過時了」。沉寂三年後,他在 2026 年 4 月推出了「AI Second Brain」課程,核心主張是:
「個人脈絡管理(Personal Context Management)正在取代個人知識管理——新的瓶頸不是 AI 的能力,而是你給 AI 正確資訊的能力。」
這與 Karpathy 的觀點形成了完美的呼應:人類的角色從「整理知識」轉變為「策展脈絡」。你不再需要手動建索引、寫摘要、維護交叉引用——這些是 LLM 的工作。你需要做的是:選擇值得讀的資料、問對的問題、判斷什麼重要。
微軟研究院在 CHI 2025 的「Tools for Thought」專案中也發現了類似的動態:「對 AI 的信心越高,批判性思考越少;對自身能力的信心越高,批判性思考越多。」他們建議 AI 應該扮演「思考夥伴」而非「答案機器」——LLM Wiki 恰好符合這個定位。它不是給你答案的工具,而是幫你建構理解的系統。
從更大的視角看,McKinsey 估計生成式 AI 每年可釋放 $4.4 兆的生產力;60-70% 的知識工作活動在技術上可以被自動化。但 Harvard/Metaintro 的研究顯示,自動化密集的職位減少了 17%,而人機協作的職位增加了 22%。未來不是 AI 取代知識工作者,而是知識工作者的工作內容從「記帳」轉向「策展」。
結語:你的 Memex,終於可以造了
1945 年,Vannevar Bush 夢想了一台能儲存、連結、組織個人知識的機器。他描述了「聯想路徑」——文件之間由人類策展的連結——並預見這些連結本身與文件同等重要。他唯一沒能解決的問題是:誰來做維護?
80 年後,LLM 回答了這個問題。
Karpathy 的 LLM Wiki 不是一個產品,甚至不是一個完整的解決方案。它是一個模式(pattern)——一個關於 AI 應該如何與人類知識互動的設計直覺。它有真實的限制:規模瓶頸、成本門檻、幻覺風險、認知代價。但它指向了一個正確的方向:AI 不該只是搜尋引擎的升級版,它應該是你的知識管家。
在這個模式下,你的工作變了。你不再是知識的記帳員,而是知識的策展人。你選擇讀什麼、問什麼、追蹤什麼——LLM 負責其餘的一切。
就像 Karpathy 說的:「維護知識庫最無聊的部分不是閱讀或思考——而是記帳。」
現在,記帳員下班了。策展人的時代開始了。
參考資料
- Andrej Karpathy — LLM Wiki (GitHub Gist) — Karpathy 提出的 LLM Wiki 模式原始文件
- Vannevar Bush — As We May Think (The Atlantic, 1945) — 最早提出 Memex 個人知識機器概念的經典文章
- Overcoming the "Impracticality" of RAG (arXiv:2604.02640) — 提出 RAG 系統在真實企業場景準確率僅 9-17% 的研究
- Not Wrong, But Untrue: LLM Overconfidence in Document-Based Queries (arXiv:2509.25498) — 測量 NotebookLM(13%)與 ChatGPT(40%)幻覺率的研究
- Barnett et al. — Seven Failure Points When Engineering a RAG System (arXiv:2401.05856) — 歸納 RAG 系統七個結構性失敗點的經驗報告
- Shumailov et al. — AI Models Collapse When Trained on Recursively Generated Data (Nature, 2024) — Nature 上關於模型崩潰現象的研究
- qmd — Tobi Lutke (GitHub) — Shopify CEO 開發的本地端 Markdown 搜尋引擎,結合 BM25、向量搜尋與 LLM 重排序
- sage-wiki — xoai (GitHub) — 用 Go 寫的 LLM Wiki 編譯器,五階段漸進式處理管線
- openaugi — bitsofchris (GitHub) — 將 Obsidian vault 轉換為 SQLite 知識圖譜並透過 MCP 暴露給 Claude
- rohitg00 — LLM Wiki v2 (GitHub Gist) — 加入信心分數、知識衰減與多層記憶整合的 LLM Wiki 延伸設計
- Tiago Forte — The AI Second Brain — Forte 提出「個人脈絡管理」取代傳統個人知識管理的新課程
- Microsoft Research — Tools for Thought (CHI 2025) — 探討 AI 對批判性思考影響的研究,發現對 AI 信心越高、批判性思考越少
- McKinsey — The Economic Potential of Generative AI — 估計生成式 AI 每年可釋放 $4.4 兆生產力的報告
- Harvard Business School — Research: How AI Is Changing the Labor Market (HBR, 2026) — 自動化密集職位減少 17%、人機協作職位增加 22% 的研究
- Epsilla — Did Karpathy's LLM Wiki Just Kill RAG? The Enterprise Verdict — 從企業角度分析 LLM Wiki 模式限制的文章