本文涵蓋 2026-07-06 至 2026-07-12(Asia/Taipei,W28)。本週三條線指向同一結論:agent 的能力層快速平台化,但真正限制生產價值的是長任務可靠度、工具權限與可觀測性。
本週三篇深讀
- 產業:模型成為 Agent 執行層(GPT-5.6、Muse Spark 1.1、GPT-Live)
- 研究:長任務失敗不是單點錯誤(Failure Taxonomy、OSWorld 2.0、PlanBench-XL)
- 開源:Skills、MCP 與 Harness 成為可組裝基礎設施
一張圖景:能力下沉,責任上升
GPT-5.6 把 persisted reasoning、programmatic tool calling 與 multi-agent orchestration 放進模型平台;Muse Spark 1.1 把長脈絡、subagents、MCP、computer use 與 coding harness 結合;GPT-Live 與 Muse Image 則讓語音和影像介面可直接採取行動。agent runtime 的「標準配備」正在快速增加。
研究卻提醒我們,長任務會把小錯放大。OSWorld 2.0 的專業工作流、PlanBench-XL 的失效工具,以及跨 benchmark failure taxonomy 都顯示:規劃、狀態、工具恢復、協調與評測不能拆開看。會做單一步驟,不等於能負責結果。
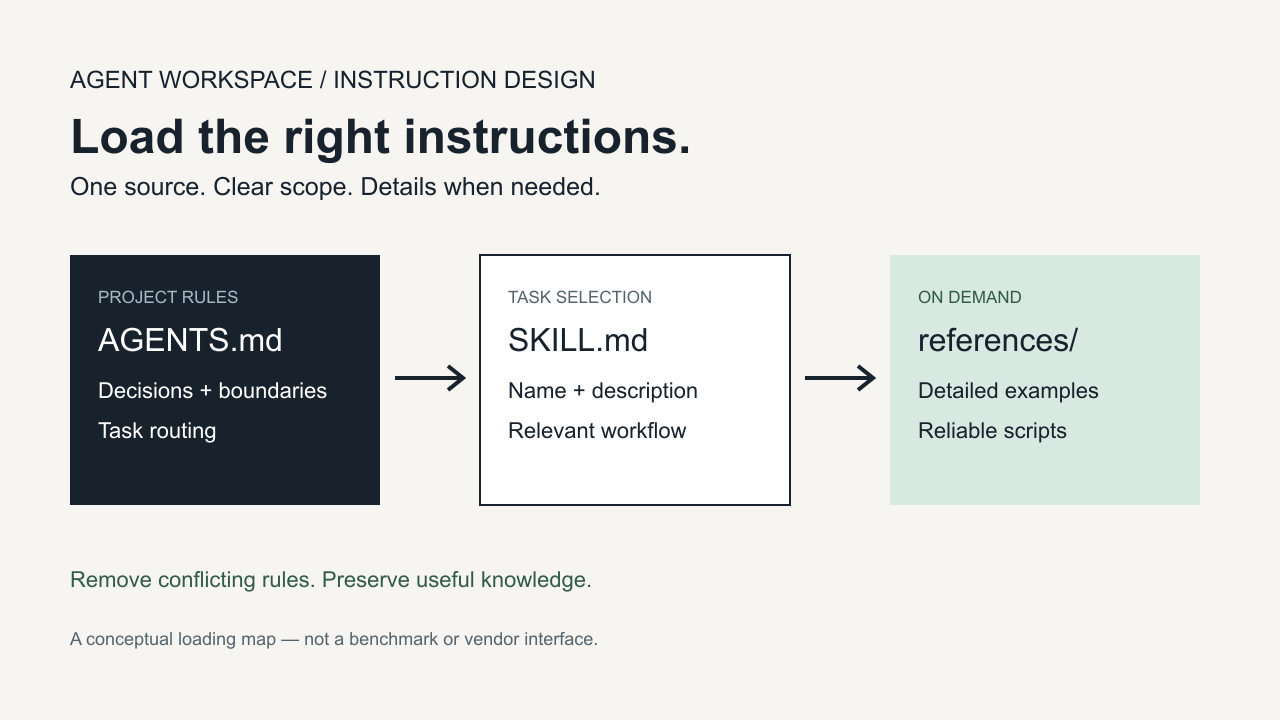
開源社群提供了另一半:skills 保存程序、MCP 暴露工具、harness 管理組態。但每增加一個能力,也增加 prompt injection、憑證外洩、不可逆操作與供應鏈風險。下一代 agent stack 需要 capability manifest、版本鎖定、trace、checkpoint 與人工升級路徑。
給實作者的結論
不要只問「哪個模型最好」,應測量:端到端完成率、每次成功成本、錯誤可恢復率、人工介入點、權限範圍,以及完整軌跡能否重現。模型、research benchmark 與 open-source stack 已經在同一個系統問題上會合。
Watchlist
- 原生 multi-agent API 是否形成共同 trace / state 標準。
- 長任務 benchmark 是否被企業採用為 regression suite。
- Agent Skills 與 MCP 是否加入 provenance、簽章與權限 manifest。
- 語音/多模態 agent 對敏感動作的確認與復原設計。
- 部署團隊是否公布完整率、成本與事故資料,而非 demo 數量。