把果蠅腦搬上 Loihi 2:connectome 能跑,腦還不能被重建
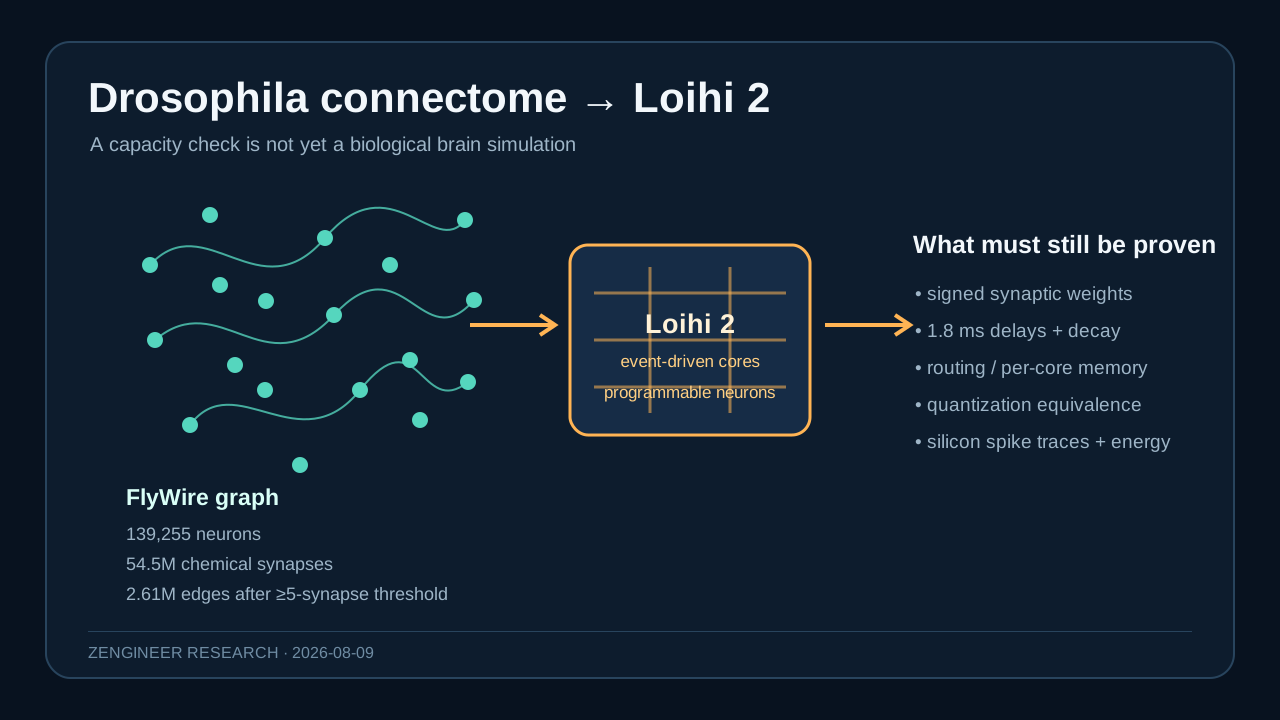
2024 年 10 月,我看到 FlyWire 的果蠅全腦 connectome 數字時,第一個念頭不是「這離 AGI 又近了一步」。比較像是在看一台剛被拆開、零件數量剛好落在工程師能想像範圍內的機器:139,255 個 proofread neurons、5,450 萬個化學突觸,外加一張可以下載、查詢、再分析的接線圖。
那個問題很自然會出現:既然 Intel Loihi 2 一顆晶片宣稱最多能放 100 萬個神經元與 1.2 億個突觸,能不能把這隻果蠅的腦搬上去?
短答是:在總容量的第一關,答案看起來是可以;在「這就是果蠅的腦」這個較強的說法上,答案是不可以。 中間差的不是一個更大的 CSV,而是神經動力學、身體回饋、硬體映射,以及我們願意把多少假設藏在「模擬」兩個字裡。
先把「全腦」說準:這是一張成年雌蠅的大腦接線圖
FlyWire 的主論文描述的是一隻成年雌性 Drosophila melanogaster 的 central brain 與兩側 optic lobes。資料包含 139,255 個神經元、5,450 萬個化學突觸,以及超過 8,400 種細胞類型的腦區與神經傳導物質預測。Nature 的原始論文也特別說明,這是 chemical synapses;electrical synapses 仍不在這份資料裡。
它也不是「整隻果蠅的 nervous system」。ventral nerve cord、肌肉、感覺器官如何把光、味道、觸覺變成輸入,以及 motor output 如何真的移動身體,都還需要額外資料。這個限制很重要:沒有 body loop,就不能把晶片上的 spike 直接叫做「飛行」或「覓食」。
如果把圖視為一個有向加權 graph,Network Statistics 那篇 companion paper 在 FlyWire v630 上採用每對神經元至少五個 synapses 的 threshold,得到 127,978 個 neurons 與 2,613,129 條 connections。原始分析還報告,93.3% 的神經元位於同一個 strongly connected component,平均最短有向路徑是 4.42 hops。這不是一張單純由感覺器官流向馬達的 feed-forward graph,而是一個稀疏、強烈 recurrent 的網路。
這個 threshold 是工程上的好切口。54.5M 是 synapse-level 的數字;2.61M 則是把同一對神經元之間的多個 synapses 聚成一條加權 edge 之後的 graph。兩者不能混用,否則很容易在宣稱硬體容量時少算或多算一個數量級。
其實已經有人先做了「可計算的果蠅腦」
在談 Loihi 2 之前,應先看 Shiu 等人的工作。這篇研究沒有把每個神經元的 morphology、receptor dynamics 和內部狀態全部重建,而是用一個全腦 leaky integrate-and-fire(LIF)模型,把 connectome 的 connection weight 與 neurotransmitter identity 轉成脈衝網路。Nature 論文
模型的選擇很樸素,但樸素不等於沒有用。神經元膜電位向 resting potential 衰減;上游 spike 讓下游的 synaptic conductance 增加;conductance 再以 5 ms 的時間常數衰減;超過 threshold 後發 spike 並 reset。原始模型使用 -52 mV 的 resting/reset potential、-45 mV 的 threshold、20 ms 的 membrane time scale、2.2 ms 的 refractory period、1.8 ms 的 synaptic delay,以及每個 synapse 0.275 mV 的自由權重參數。這些細節都寫在論文 Methods,而不是我替它補上的「腦科學直覺」。
更關鍵的是驗證方式。作者把 sugar、water 和 mechanosensory neurons 當成輸入,觀察模型是否能預測 feeding、proboscis extension 與 antennal grooming 相關的下游活動;在 164 個有實驗資料可比對的 predictions 中,91% 與實驗結果一致。作者也公開了模型 code 與資料入口。
這給 Loihi 2 一個很好的 reference oracle:第一個工程目標不必是「模擬一個活的果蠅」,而是先讓另一個 event-driven backend 得到與 Brian2 相同的 spike rate、target-neuron ranking 和延遲行為。只有先對齊這些,談硬體上的 energy 或 latency 才有意義。
Loihi 2 的容量計算:可以,但只算到門口
Intel 的 Loihi 2 技術 brief 列出的單晶片上限是 128 個 neuromorphic cores、100 萬個 neurons 與 1.2 億個 synapses;每個 core 都把一組 spiking neurons 與它們的 synapses 放在一起。Loihi 2 也支援 programmable neuron models、graded spike payload,以及稀疏連線的記憶體壓縮。Intel brief
拿最保守的 headline capacity 先做除法:
| 項目 | FlyWire model | Loihi 2 單晶片 headline capacity | 粗略佔用 |
|---|---|---|---|
| neurons | 139,255 | 1,000,000 | 13.9% |
| synapses | 54.5M | 120M | 45.4% |
| thresholded connections | 2.61M | 不等同於 synapse 上限 | 不能直接比較 |
所以,若只問「數量會不會立刻超過晶片規格」,答案是不會。這也是這個題目值得做的地方:它不是只能在超級電腦上想像的規模。作為參考,Intel 的 Hala Point 是由 1,152 顆 Loihi 2 組成,總容量約 11.5 億 neurons、1,280 億 synapses;那個系統證明的是多晶片 neuromorphic fabric 的規模,不是這個 fly graph 已經在 Hala Point 上跑過。Intel 對 Hala Point 的說明
真正的風險在 headline capacity 之後:
- graph 要怎麼切到 cores,才不會讓少數高 degree neurons 把單一 core 的 synaptic memory 或 routing table 撐爆?
- 原始模型的 signed weight、1.8 ms delay、alpha-like conductance decay,能不能在 Loihi 2 的 process model 中保留相同語義?
- neurotransmitter prediction 被壓成每個 neuron 一個 excitatory/inhibitory sign 時,硬體上的 integer weight 與有限 precision 會不會改變下游 neuron 的排序?
- 如果所有 neuron 都以固定 time step 更新,原本 event-driven 的優勢會不會被不必要的 baseline activity 消耗掉?
這些問題不能用「Loihi 2 有一百萬神經元」回答。它們要靠 compiler mapping、small-subgraph tests 和真正的 silicon traces 回答。
我會怎麼把它做成一條可重現的路徑
最合理的架構不是先把資料灌進硬體,而是先做兩個互相約束的模型:一個是科學上的 reference model,一個是硬體形狀的 event model。
flowchart LR
  A[FlyWire materialization v630] --> B[stable neuron IDs + sparse edge list]
  B --> C[Brian2 reference LIF]
  B --> D[Lava CPU event model]
  C --> E[spike traces / rates / target ranking]
  D --> E
  D --> F[Loihi 2 mapping]
  F --> G[hardware spike traces + energy]
  E --> H{same scientific result?}
  G --> H
  H -->|pass| I[add VNC/body loop]
  H -->|fail| J[inspect quantization, routing, dynamics]
第一階段固定 FlyWire materialization 版本,產生穩定 neuron ID 與 CSR/COO sparse edge list。不要一開始追最新 snapshot;版本固定比數字看起來最新更重要。
第二階段重跑 Shiu 模型的一個公開實驗,例如 sugar-sensing input 到 feeding motor output。比較的不只是最後平均 firing rate,還要保存 spike times、latency distribution、被啟動的 neuron ranking,以及不同 random seed 的 spread。這一步是在防止「兩個模型都輸出一張漂亮 heatmap,但其實算的是不同東西」。
第三階段把相同方程式寫成 Lava 的 CPU process。Lava 的設計允許先在 CPU/GPU 開發,再把 process 映射到 neuromorphic backend;文件也有 Loihi2NeuroCore 與對應 run configuration 的介面。Lava 文件 所描述的是開發與 mapping 的抽象層,不是這個特定果蠅模型已完成的硬體部署。
第四階段才開始縮放:1,000 個神經元、單一 neuropil、單側腦、最後才是完整 thresholded graph。每一關都要回答同一組問題:memory 使用量、跨 core traffic、spike count、延遲、以及與 Brian2 的 divergence。
這裡最容易誇大的地方:connectome 不是 dynamics
Shiu 團隊自己把限制列得很清楚:模型把每個 neuron 當成相同的 spiking unit,忽略 morphology 與不同 receptor dynamics,也不包含 gap junctions、non-spiking neurons、internal state、long-range neuropeptides,並假設 basal firing 為零。作者因此把模型定位成能產生可測試 sensorimotor hypotheses 的工具,而不是完整 physiology。
這不是吹毛求疵。connectome 告訴我們「誰連到誰」,不自動告訴我們每條連線在什麼狀態下有效、突觸如何被調制、同一個 neuron 如何依據 hunger 或 thirst 改變 response,也不告訴我們腳和翅膀如何把 motor spike 反饋回腦。
因此我會把成果分成三個名稱:
- connectome-driven spiking model:拓撲與權重來自 FlyWire,神經動力學是明確的簡化模型。
- Loihi 2 deployment:上一個模型在 Loihi 2 backend 上編譯、執行並通過 trace/energy 對照。
- fly brain simulation:還需要更完整的 neuron classes、neuromodulation、VNC 與 body loop,並且要以行為資料驗證。
現在公開資料已經讓第一項很實際,第二項值得做,第三項則還不能靠一張 capacity table 宣布完成。
取得硬體的現實限制
Lava 的 CPU 部分是開源的,公開文件也提供跨平台的 process、compiler 與模擬概念;但 Intel 的 Loihi 2 brief 同時寫明,部署到 Loihi 2 所需的較低階敏感元件只對符合資格的 Intel Neuromorphic Research Community 成員開放。換句話說,任何人都可以把問題整理成 Lava-shaped model,不能因此暗示任何人都能在本機下載一個完整 Loihi 2 emulator 並重現 silicon 結果。
截至本文研究日,Lava 的公開 GitHub repository 顯示為 archived。這不等於既有程式碼失效,但代表真正要做這個 project 時,應該 pin release、保存本地依賴與 compiler artifact,不要把可重現性押在一個會自動漂移的 main branch 上。Lava repository
我這次成功抓下來的是 FlyWire/模型相關論文、Intel Loihi 2 brief,以及作者公開 model source archive;沒有把完整 FlyWire 原始 EM volume 當成「下載成功」來冒充。對這個工程問題來說,真正需要的是 materialized connectivity、cell annotations 與 neurotransmitter predictions,而不是幾十 TB 的影像原檔。
結論:先證明 event semantics,再談腦
把果蠅 connectome 搬上 Loihi 2,最有價值的版本不是一個「AI 已經變成昆蟲」的 headline,而是一個很精確的 systems experiment:固定一份可引用的 wiring diagram,保留一個已經和實驗對過的 LIF reference,將它轉成 event-driven process,然後量出 mapping、quantization、latency 與 energy 的代價。
若完整圖在 aggregate capacity 上真的能塞進單晶片,那是很好的結果;若最後因 routing 或 dynamics 只能拆成多晶片,也仍然是有意義的工程邊界。真正需要避免的是把「139,255 個 node 可以放進記憶體」寫成「我們模擬了果蠅的大腦」。前者是一個可以測的 claim,後者目前還差一個身體、一套狀態變數,以及更多實驗。
參考資料
- Dorkenwald et al., Neuronal wiring diagram of an adult brain, Nature (2024).
- Lin et al., Network statistics of the whole-brain connectome of Drosophila, Nature (2024).
- Shiu et al., A Drosophila computational brain model reveals sensorimotor processing, Nature (2024).
- Intel Labs, Taking Neuromorphic Computing with Loihi 2 to the Next Level, Technology Brief.
- Intel, Hala Point.
- Lava documentation and Lava source repository.
- Drosophila brain model source and data pointers.