別讓 AI 重學三百年物理:PIML 真正重要的不是多一個 Loss
整理這份 9,800 行逐字稿時,我第一個停下來的不是偏微分方程,而是一顆青椒。
2026 年 8 月 11 日中午,林秀豪老師在 NeuroAI Summer School 把照片切成 8×8 pixel patches,問台下:一張自然影像裡,到底有多少資訊是我們真的需要的?逐字稿接著記下他展示只保留少數主要成分的重建結果。青椒只是入口;真正的問題是:既然自然影像、電子流動和分子振動都不是白噪音,為什麼還要讓神經網路假裝自己對世界一無所知,重新從資料裡學一次?
這是 Physics-Informed Machine Learning(PIML,物理資訊機器學習)最有力的主張,也是最容易被說得太滿的地方。
我的結論是:PIML 真正的槓桿,不只是在 loss function 多放一條方程式,而是用可檢驗的科學先驗,排除某些候選解,或降低它們在訓練中的優先順序。搜尋可能因此更有效率;可是先驗一旦選錯,模型也可能更有效率地走向錯誤。
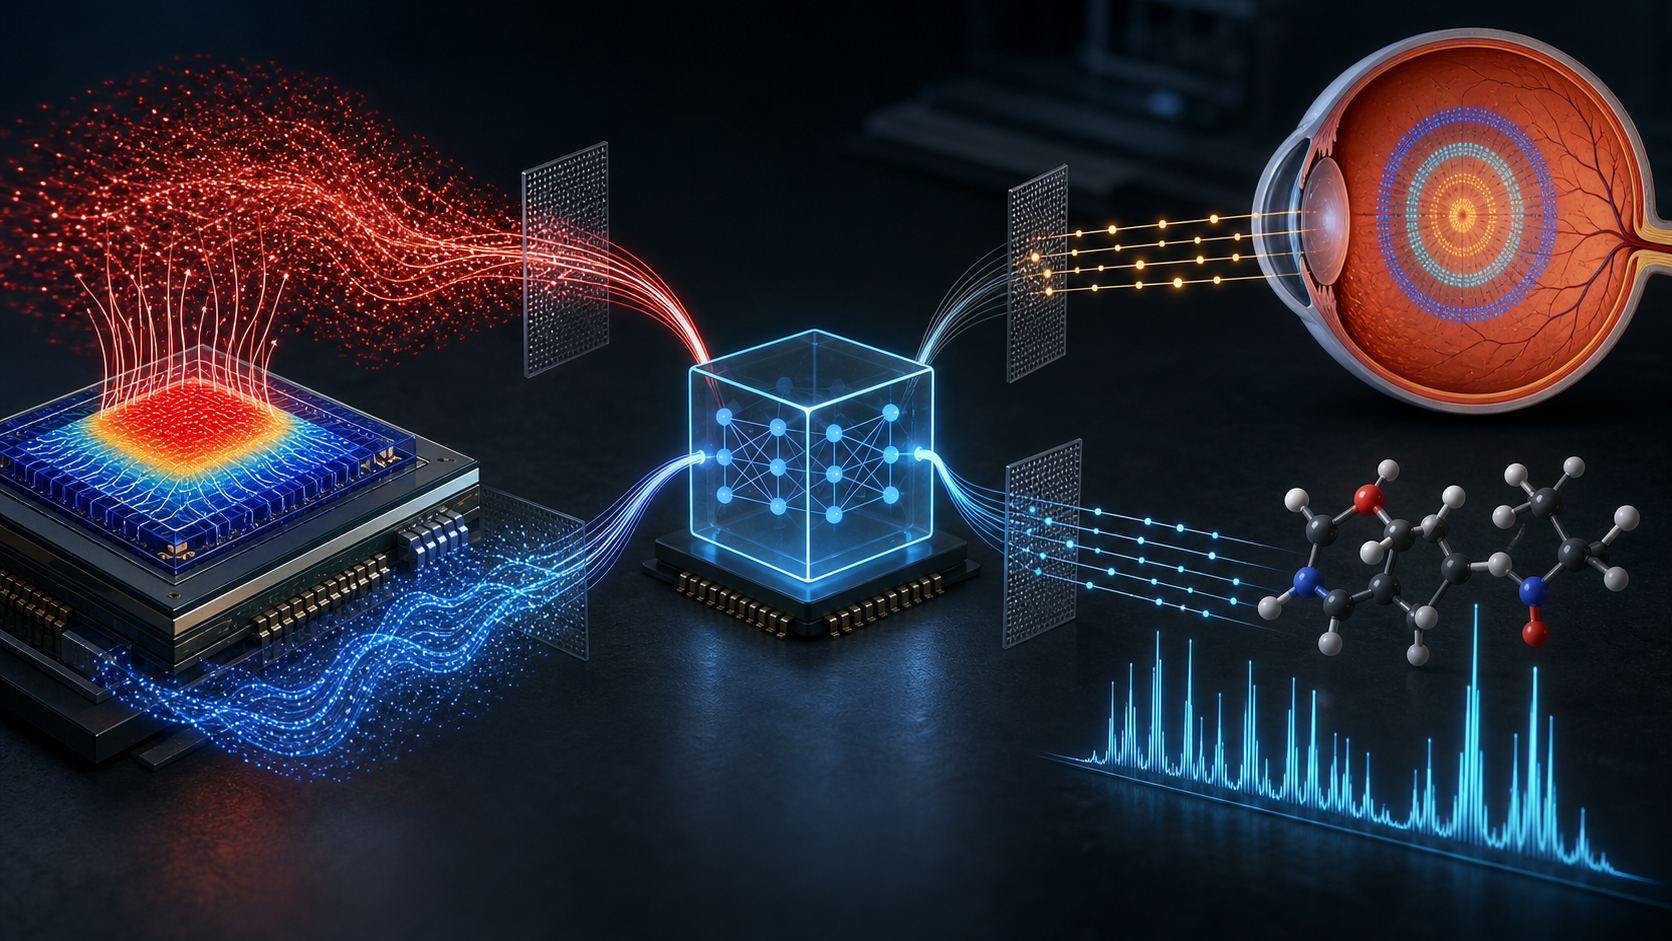
本文把課堂展示視為啟發性的案例。由於完整設定與驗證沒有公開,我不會把其中的數字升格為可泛化的 benchmark;能由論文支持的部分,則會把證據與適用範圍寫清楚。文章先用 PINN 說明 physics loss 的成本與失敗模式,再回到 Edge AI、晶片散熱、視網膜與嗅覺,看科學先驗究竟放在哪裡。
問題不一定是資料太少,而是搜尋空間太大
一般的 supervised learning 把輸入、標籤與模型準備好,剩下的交給 optimization。這套做法在網路資料充足的領域很成功,但科學與工程問題通常有另一種形狀:實驗昂貴、量測不完整、極端狀態難以取得,偏偏系統又受守恆律、對稱性、幾何與微分方程約束。
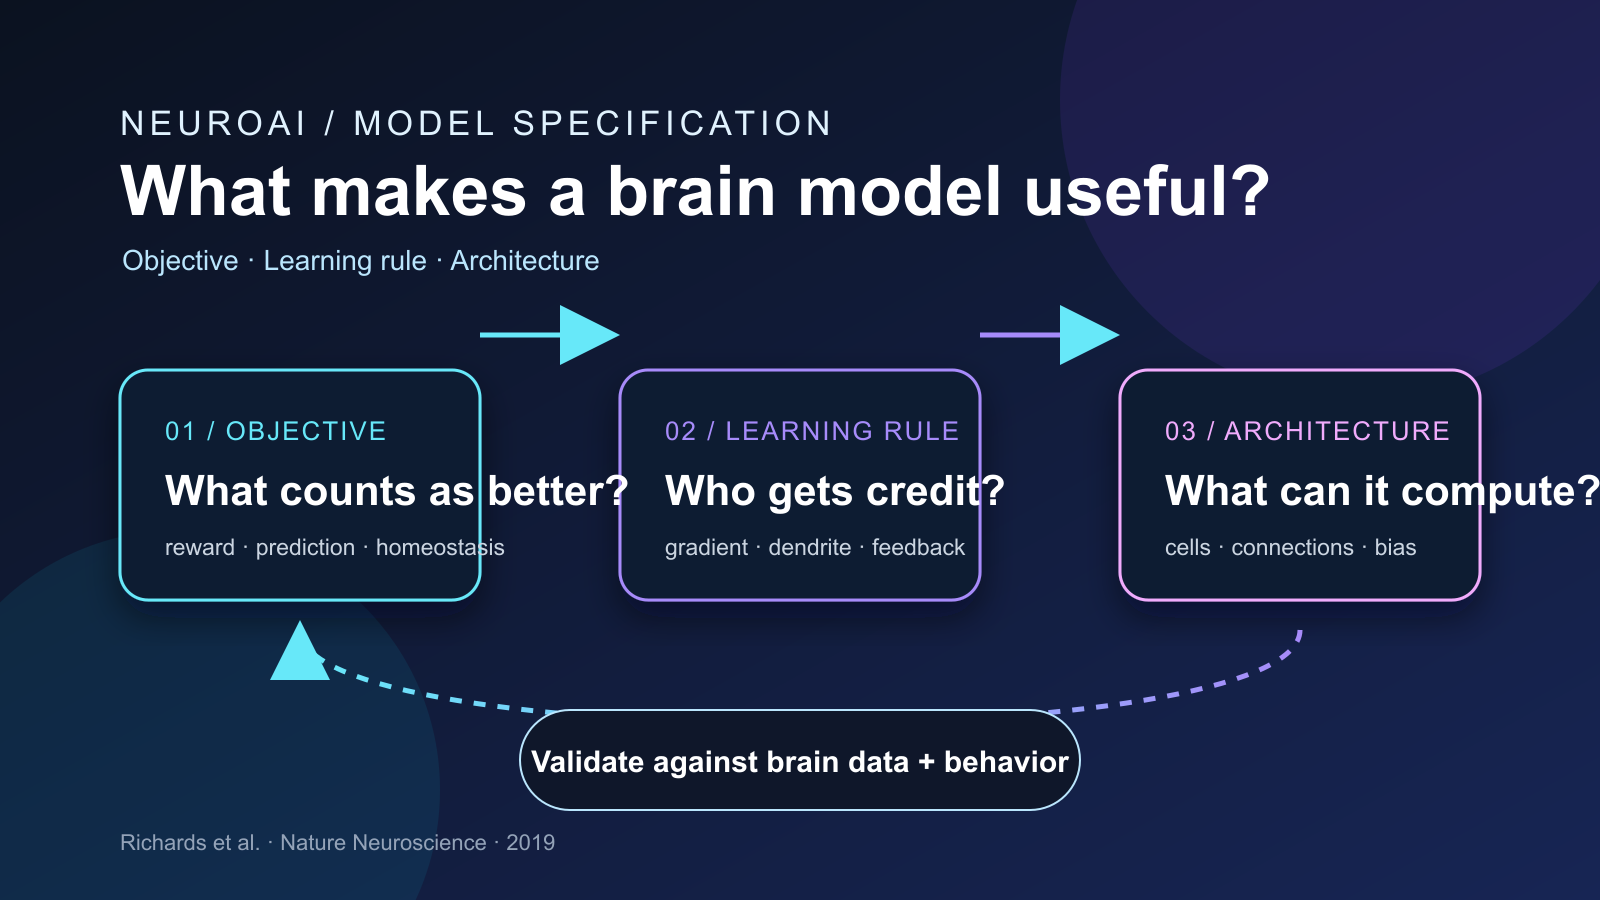
2021 年的 Physics-informed machine learning 綜述把物理放進學習系統的方式分成 observational、inductive 與 learning biases。換成工程實作,可以看成四個把手:
- Data:用模擬器產生資料、融合不同精度的量測。
- Representation:先把原始輸入轉成有科學意義的變數。
- Architecture:讓模型遵守對稱性、Hamiltonian 或守恆結構,或把已知微分方程的一部分嵌進 state evolution。
- Loss:用方程式殘差、初始條件與邊界條件提供 soft constraints。Physics-Informed Neural Network(PINN)主要屬於這一類。
這四種手段的力度不同。Hard architectural constraints 會重畫模型能走的路;soft physics loss 則比較像替某些路提高通行成本。前者若設錯,可能直接排除真解;後者若設錯,會持續把 optimization 推向錯誤區域。PINN 是 PIML 的一種,不是同義詞。
「只用 100 個資料點」背後,還有 10,000 個物理約束
經典 PINN 論文由 Maziar Raissi、Paris Perdikaris 與 George Karniadakis 在 2019 年發表。他們用神經網路近似未知場 uθ(t, x),再用 automatic differentiation 計算方程式殘差。概念可以壓成一行,其中 λ 控制物理殘差在總 loss 裡有多重:
在著名的 Burgers equation 實驗裡,原始論文用這條非線性 PDE 描述具有對流與黏性的波形演化。Benchmark 使用 100 個初始與邊界 solution values,再加入 10,000 個 collocation points,也就是沒有 solution labels、但會被檢查 PDE residual 的採樣位置。
這是一個重要而常被省略的細節。方程式在這裡提供額外 supervision,但 10,000 個位置仍要計算微分與 residual;原論文也沒有做「因此省下 10,000 次實驗」的比較。PINN 減少的可能是昂貴的標註或量測需求,不是取消訓練訊號,更不是零成本。
也因此,PIML 最有吸引力的地方往往不是解一次已知方程,而是反推未知參數、融合稀疏量測,或為同一類參數化系統建立可以重複查詢的 surrogate model(代理模型)。
PINN 也會卡住,而且有時候 FEM 就是比較好
物理 loss 甚至可能讓 optimization 更難。
Krishnapriyan 等人在 NeurIPS 2021 的 failure-mode study 裡測試 convection、reaction 與 diffusion problems。當一維 convection coefficient β 大於 10,vanilla PINN 的 relative error 接近 100%。問題不是 network 不夠大;同一架構能表示正確解,真正卡住的是 PDE soft regularization 讓 loss landscape 變得難以最佳化。
換成 curriculum regularization,逐步增加 PDE 難度,或把整段時空問題拆成 sequence-to-sequence training,在這些測試中,誤差能降低一到兩個 orders of magnitude。這顯示 failure 可以改善,也顯示「有物理」不等於「好訓練」。
另一個問題更根本:如果物理骨架本身不完整呢?Zou、Meng 與 Karniadakis 在 model-misspecification study 中,刻意使用遺漏過程或錯誤 constitutive relation 的模型;結果顯示,錯誤先驗會降低 PINN prediction accuracy。他們加入可學習的 discrepancy network,讓資料有機會修正不完整的物理骨架。這正是「保留掉頭能力」的具體做法。
2024 年一篇直接問 Can physics-informed neural networks beat the finite element method? 的研究,在測試的單次 forward PDE benchmarks 上得到很樸素的答案:vanilla PINNs 沒有勝過 FEM。Finite Element Method(有限元素法)在相同或更高準確度下更快;已訓練 PINN 的 pointwise evaluation 有時較快,但 offline training cost 足以吃掉優勢。這個結果不能外推到所有 improved PINNs、neural operators 或 amortized solvers,卻足以提醒我們:若只想解一次條件完整的 PDE,成熟 numerical solver 通常是起點。
那它為什麼和 Edge AI 有關?
我沒有找到一個能支撐「PIML 讓所有 Edge AI 快 N 倍」的一般 benchmark。這個關係目前比較像需要逐案驗證的工程假說。
Edge device 的限制是記憶體、latency、energy、通訊與可取得的資料。如果經過驗證的科學表示能先去除不相關輸入,模型可能變小;如果架構排除了物理上不可能的行為,可能不需要靠參數量把所有 case 背起來;如果高成本模擬已被攤提成 surrogate,edge 端可能只需執行快速 inference。
但「可能」最後仍要用裝置上的 peak memory、wall-clock latency、energy per inference 與 out-of-distribution error 驗證。訓練資料變少,不代表部署自動更省電;server 上的 surrogate 變快,也不等於它塞得進 microcontroller。
晶片散熱:把重複模擬變成預付成本
對我來說,半導體最能說明 amortization:先付一次昂貴建模成本,再用很多次快速查詢把它攤薄。
元件走向三維堆疊後,熱不再只是某顆 transistor 自己的問題。一個元件的 self-heating 會沿著材料與介面傳播,變成鄰近元件的 cross-heating。130 nm、雙層 3D IC 的實體量測中,兩個垂直對齊的 active blocks 同時運作時,各感測點相對單一 heat source 的溫升約增加 56.5% 到 79.4%。這支持「層間熱耦合是真實問題」,但數值只適用於該測試結構。
林秀豪老師與台積電研究者在 2025 年發表的 A statistical-field approach to electron transport in semiconductor nanodevices,主張先辨識元件所在的 diffusive、ballistic 或 viscous transport regime,再以局部溫度與 chemical potential 等統計場描述能量與粒子流,並把 electron interactions 與 heat dissipation 納入同一套自洽框架。這與課堂中「避免只靠逐製程 empirical fitting」的工程方向一致;不過這是一篇 Perspective,不是完成工業驗證的研究,作者也把 boundary conditions 列為待解問題。
課堂接著用 CFET(Complementary Field-Effect Transistor,互補式場效電晶體)的散熱 sandbox,比較橫向 heat spreader 與垂直散熱通道。展示結果是:橫向結構主要降低 self-heating,垂直通道則同時壓低 self- 與 cross-heating。
公開資料不足以讓我重現這張圖。現有研究提供的邊界是:垂直高導熱路徑的效果取決於它是否真正連到 heat sink;密集的 through-silicon vias(TSVs)也可能改善垂直導熱,卻阻塞橫向擴散。另一方面,單一 lumped thermal resistance 難以描述多熱源與三維耦合,不代表所有熱阻模型失效;distributed RC network 或直接求解 heat equation 都仍是有效工具。
PIML 的價值在另一個地方:它能把昂貴模擬攤提到後續的大量查詢。
一篇獨立於課堂 CFET sandbox 的 IEEE TCAD 研究,先用 finite-element model 產生積體電路溫度場資料,再比較 ANN、POD-RBF 與 POD-RBF-ANN 三種 surrogate。若採廣義 PIML 分類,這裡的 physics 位在 data generation,不是 architecture 或 loss;作者也明確把三種 surrogate 視為不含 governing equations 的 black-box methods。39 組 training configurations 涵蓋 11 個靜態 inputs,ANN 與 POD-RBF-ANN 在三個隨機測試點的 relative error 約 2%。依方法不同,online prediction 相對 finite-element baseline 快約 67 到 7,500 倍;一般 ANN 約 3,460 倍,最快的是 POD-RBF-ANN。
可是帳單沒有消失。建立離線模擬資料花了約 472 分鐘;把 power 外推到訓練範圍的 200% 時,誤差明顯惡化。Surrogate 不是免算,而是把每一次的昂貴求解,改成先付一次錢。只有查詢夠多,而且 deployment 沒有跑出驗證過的 operating envelope,這筆預付才值得。
NVIDIA PhysicsNeMo 則顯示 PINNs、neural operators、graph neural networks 等方法正被整合進同一套公開工具鏈;這與任何 proprietary chip case 是否被公開重現,是兩件不同的事。
Retina 的確做了前處理,但它不是一顆精確的 Laplacian
青椒案例之所以迷人,是因為它把機器學習和神經科學接在一起。從這裡開始,案例走到廣義的 science-informed ML:重點不是把 PDE 寫進 loss,而是讓科學假說決定 representation。
自然影像的相鄰 pixels 高度相關,低空間頻率帶著大量能量。早在 1992 年,Atick 與 Redlich 就在 What Does the Retina Know about Natural Scenes? 提出:retina 的工作之一,可能是依自然場景統計做 noise-aware whitening,壓掉可預測的冗餘,同時保留局部 contrast。這個 whitening 並不完整,因為低光源與神經噪音也要付成本。
2012 年的 Efficient Coding of Spatial Information in the Primate Retina 更進一步,把靈長類 cone 到四種主要 retinal ganglion cells 的 functional connectivity,與受神經資源限制的最適模型直接比較。依這個假設 linear processing、Gaussian signal 與 noise,且只處理 spatial information 的模型,實測 retina 傳遞的資訊約達理論上限的 80%。
這支持一個很漂亮的觀點:世界的統計規律與生物的資源限制,會共同塑造感知編碼。它沒有證明 retina 只為了一個 objective 演化,更沒有證明每個 ganglion cell 都在逐點執行 Laplacian operator。
經典 retinal receptive field 是 center-surround,常用 Difference of Gaussians(DoG,高斯差)近似;在適當的 Gaussian width ratio 與 normalization 下,它與 Laplacian of Gaussian 的形狀接近。不過 oriented、Gabor-like filters 是 V1 simple cells 與 natural-image sparse coding 的經典故事,不該全部塞回 retina。
還有一個更麻煩的結果。Pitkow 與 Meister 對 salamander retinal ganglion cells 的 recordings 顯示,retina 的確會 decorrelate 自然影像,可是大部分效果不是線性 receptive field 單獨完成,而是來自 nonlinear thresholding 與 sparse firing。只把視網膜畫成一個 Laplacian filter,會漏掉真正重要的非線性。
所以我會保留課堂的方向,放下課堂的數字。逐字稿裡「只剩 9% 資訊」、「訓練效率十倍」以及「50 層 DNN 有 95% 在重學三層 retina」都很吸睛,但我沒有找到可對應的一手論文,不能把它們寫成已被泛化驗證的 benchmark。
嗅覺:有用的 representation,不等於正確的 mechanism
嗅覺案例把這個風險放到最大。
課堂討論的假說是:odorant 進入 receptor 後受到局部電場影響,分子的振動特性可能成為氣味表示。這類 isotope test 的巧思,是把氫換成氘:分子整體形狀近似,振動頻率卻會改變。講者把 IR spectrum 依室溫能量尺度切成高維向量,展示 12 個 molecules 在沒有 labels 的情況下,透過 clustering 被分成四種氣味類別。
最接近的公開研究是 2021 年的 Vibration-based biomimetic odor classification。它以 atomistic simulation 建立 vibration-derived PD-EVA pseudo-spectrum,對 20 個 molecules、六個事先指定的 perceptual classes 建立 similarity graph,再做 spectral embedding 與 k-means。這不是逐字稿裡「直接將 12 個 IR vectors 用 K-means 分成四類」的同一實驗;小而事先挑選的資料集,也不能外推成一般 odor-prediction benchmark。
更重要的是,「振動 feature 能分類氣味」與「鼻子靠振動讀取氣味」是兩個不同命題。
支持方並不是沒有資料。2011 年的 Drosophila 實驗顯示,果蠅能區分一般與氘化 odorants,還能把對氘化物的制約轉移到具有相近振動 band 的另一種 molecule。研究作者將結果解讀為與 shape-only model 不一致,並視為振動成分的支持證據;但它仍不是 receptor-level mechanism 的直接證明。
可是 2015 年的 receptor-level study 得到反面結果:研究者測試人類與小鼠 olfactory receptors 對一般、氘化和 carbon-13 isotopomers 的反應,沒有找到支持所提振動機制的 receptor evidence。2019 年更接近原生細胞環境的 single-neuron study 共測試 23,812 個 mouse olfactory receptor neurons,其中 1,610 個對至少一種 odorant 有反應。以全部受測細胞為分母,只有 0.81% 顯示 H/D discrimination;作者並指出,少數差異可能來自氫化物與氘化物的疏水性差異,而非振動辨識。整體證據不利於「普遍的 receptor-level vibration mechanism」,但尚不足以排除所有物種或情境中的振動貢獻。
這不表示 vibration-derived representation 沒有工程價值。IR spectrum 本來就是分子結構、鍵結與質量的函數,它可能是一組有效 features,而不必是 receptor 的真實 readout mechanism。2023 年 Science 的 Principal Odor Map 則走另一條路:從 molecular graph 與人類 perceptual labels 學出 latent space,並在多個嗅覺任務上泛化。它同樣是好用的表示,卻也不等於完整解開嗅覺機制。
我認為這是 PIML 最該被記住的限制:模型輸出符合某條方程,或在某個 latent space 分群得很漂亮,都不能證明那條方程就是世界的機制。
之後再看到一個 PIML 專案,我會先問五件事:
- 這個 prior 有什麼獨立實驗支持,還是只因為故事很合理?
- 它放在 data、architecture 還是 loss,錯了之後模型有沒有修正空間?
- 和 FEM、FVM、傳統 signal processing 或普通 neural baseline 比,真正省掉的是什麼?Finite Volume Method(有限體積法)等成熟數值方法是否已經足夠?
- Offline 建模成本要累積多少次查詢才回本?
- 離開訓練範圍後,誰負責告訴系統「你現在不該相信我」?在真正 edge hardware 上的 memory、latency、energy 與 OOD error 又是多少?
PIML 值得做,不是因為物理永遠正確,而是因為科學提供了一批比任意函數更值得先測的假設。好的先驗會縮短路程;好的工程,還必須保留掉頭的能力。
References
- Karniadakis, G. E. et al. (2021). Physics-informed machine learning. Nature Reviews Physics, 3, 422–440.
- Raissi, M., Perdikaris, P., & Karniadakis, G. E. (2019). Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equations. Journal of Computational Physics, 378, 686–707.
- Krishnapriyan, A. S. et al. (2021). Characterizing possible failure modes in physics-informed neural networks. NeurIPS 2021.
- Zou, Z., Meng, X., & Karniadakis, G. E. (2024). Correcting model misspecification in physics-informed neural networks (PINNs). Journal of Computational Physics, 505, 112918.
- Grossmann, T. G. et al. (2024). Can physics-informed neural networks beat the finite element method?. IMA Journal of Applied Mathematics, 89(1), 143–174.
- Yang, Y.-C., Lin, H.-H., & Liao, S. S. (2025). A statistical-field approach to electron transport in semiconductor nanodevices. Nature Reviews Electrical Engineering, 2, 614–620.
- Savidis, I., Vaisband, B., & Friedman, E. G. (2015). Experimental analysis of thermal coupling in 3-D integrated circuits. IEEE Transactions on Very Large Scale Integration (VLSI) Systems, 23(10), 2077–2089.
- Zhao, S., Cai, L., Chen, W., He, Y., & Du, G. (2022). Self-heating and thermal network model for complementary FET. IEEE Transactions on Electron Devices, 69(1), 11–16.
- Shi, B. et al. (2011). Analysis and mitigation of lateral thermal blockage effect of through-silicon-via in 3D IC designs. ISLPED 2011.
- Coenen, D. et al. (2023). Benchmarking of machine learning methods for multiscale thermal simulation of integrated circuits. IEEE Transactions on Computer-Aided Design of Integrated Circuits and Systems, 42(7), 2264–2275.
- NVIDIA. PhysicsNeMo Framework documentation (accessed 2026-08-11).
- Atick, J. J., & Redlich, A. N. (1992). What does the retina know about natural scenes?. Neural Computation, 4(2), 196–210.
- Doi, E. et al. (2012). Efficient coding of spatial information in the primate retina. Journal of Neuroscience, 32(46), 16256–16264.
- Pitkow, X., & Meister, M. (2012). Decorrelation and efficient coding by retinal ganglion cells. Nature Neuroscience, 15, 628–635.
- Pandey, N. et al. (2021). Vibration-based biomimetic odor classification. Scientific Reports, 11, 11389.
- Franco, M. I. et al. (2011). Molecular vibration-sensing component in Drosophila melanogaster olfaction. PNAS, 108(9), 3797–3802.
- Block, E. et al. (2015). Implausibility of the vibrational theory of olfaction. PNAS, 112(21), E2766–E2774.
- Na, M., Liu, M. T., Nguyen, M. Q., & Ryan, K. (2019). Single-neuron comparison of the olfactory receptor response to deuterated and nondeuterated odorants. ACS Chemical Neuroscience, 10(1), 552–562.
- Lee, B. K. et al. (2023). A principal odor map unifies diverse tasks in olfactory perception. Science, 381(6661), 999–1006.