方向性學習:大腦如何知道該改哪個突觸?從資格痕跡到 NGRAD
如果只問「大腦是不是不用 backpropagation」,很容易得到一個太扁平的答案:大腦可能用 Hebbian learning、dopamine、樹突,或者某種 predictive coding。
真正困難的問題其實是:一個突觸怎麼知道自己應該往哪個方向改?
「剛才有活動」不等於「剛才的活動造成了好結果」。一個 agent 先看到路口、做出動作,幾百毫秒或幾秒後才知道拿到獎勵;在這段時間裡,神經系統要保留哪些局部活動,又要在回饋到達時把它們分成「加強」「削弱」或「不要動」。
我在把相關論文排到同一張圖上時,最容易混淆的地方正是這裡:eligibility trace、dopamine、dendritic error 和 NGRAD 都被稱為 learning signal,但它們其實處理的是不同問題。把它們放進同一個公式,差異會清楚很多。
一條先記住的規則
方向性學習可以先用這個 schematic rule 理解:
- 是 eligibility trace(資格痕跡):突觸 保存近期局部活動形成的 eligibility state。這裡的 表示「第 顆神經元連到第 顆神經元」; 是這條突觸的強度。 不只是 binary 的「參與/未參與」標籤;依規則不同,它可能保留 pre/post timing、局部敏感度,甚至正負號,但本身不知道這次行為對整體任務是好是壞。
- 是 teaching/modulatory signal(教學或調節訊號):在 neuron 所處的局部迴路中,任務結果或局部誤差提供多少學習壓力。這個訊號可以廣泛投射,也可以經由 pathway、cell identity 或 dendritic compartment 被局部化。
- 是學習率;它控制改變幅度,不提供方向。
這裡先把 的正號定義成「希望權重更新的方向」。到了工程段若把 改定義為 loss derivative,就要顯式寫成 ;兩者只是 sign convention 不同。
這不是宣稱所有腦區都使用同一個分子公式,而是一個用來拆問題的工程骨架。它把方向性學習分成三個軸:
- 資格(eligibility):延遲後要改誰?這條突觸對局部輸出有什麼敏感度?
- 任務方向(teaching/sign):這次結果要求局部輸出增加、減少,還是維持?
- 定位(assignment/addressing):訊號怎麼找到正確的 neuron、compartment 或突觸?
後面每一種方案,都是在這三個位置做不同取捨。
| 問題軸 | 要回答什麼 | 常見候選機制 |
|---|---|---|
| temporal credit | 回饋延遲後,先前活動還留著什麼? | eligibility trace、local neuron state |
| task direction | 哪個訊號表示任務層級的增加/減少壓力? | reward/sensory/motor prediction error、cell-specific learning signal |
| signal localization | teaching signal 怎麼抵達正確 neuron 或 compartment? | pathway-specific projection、feedback matrix、apical dendrite、local comparator |
這裡的「方向」還有三個尺度,後面不要混在一起讀:單一突觸的 LTP/LTD sign、每顆 neuron 各自收到的 teaching vector,以及整個更新向量和真正 loss gradient 是否對齊。reward prediction error 為正,不代表所有 hidden synapse 都應該增加;它還要和 neuron-specific signal 及 synapse-specific eligibility 結合。
時間 credit:eligibility trace 保存局部活動的影響
神經放電是毫秒尺度,行為結果常常是數百毫秒到幾秒後才出現。若突觸在活動發生的瞬間就必須完成最後更新,它根本等不到 reward 或 error。
eligibility trace 的直覺是:局部 pre-synaptic 與 post-synaptic activity 發生時,突觸先留下會衰減的暫存狀態。用最簡化的離散時間規則表示:
其中 是某種局部 Hebbian 或 spike-timing-dependent plasticity(STDP,依放電時序決定可塑性)的函數, 控制痕跡消退速度。
當延遲的訊號 到達,才發生真正的權重更新:
這裡有一個重要但容易說過頭的界線:eligibility trace 不單獨提供 task-level 的「這次結果好不好」,但它不一定是無符號標籤。在一般 three-factor/STDP 模型裡,它可以是帶有 timing 結構的 local eligibility state;在 e-prop 特例裡,它才具有由 neuron dynamics 導出的 local sensitivity/derivative 定義。如果 ,這條 schematic rule 不更新;當 到達,最後的 sign 與 magnitude 由 共同決定。Izhikevich 的 dopamine-modulated STDP 模型把這個想法用來處理 distal reward problem:局部突觸先留下帶有 STDP 結構的痕跡,延遲的 dopamine 再選擇性地改變它們。
e-prop 是這個概念在 recurrent spiking network 裡的清楚例子。它把 eligibility 定義成可在線上計算的 local gradient,再和 neuron-specific learning signal 相乘;Bellec 等人的研究顯示,這種規則可以在不完整執行 backpropagation through time(BPTT,時間展開後的反向傳播)的情況下處理時間 credit assignment。
所以 eligibility trace 解決的是「延遲之後,還找不找得到剛才的 local credit candidate/sensitivity?」它沒有單獨解決「這個局部改變對整體任務是好是壞」。
任務層級調節:dopamine 是廣域訊號,不是全腦同一個答案
在 reinforcement learning 的語言裡,dopamine 常被描述成 reward prediction error:結果比預期好,訊號偏正;結果比預期差,訊號偏負。Schultz、Dayan 與 Montague 的經典研究觀察到,中腦 dopamine neuron 的活動符合這種預測誤差的部分特徵。
放回突觸規則,dopamine 可以扮演第三因子:
表示第 條 projection/target pathway 收到的 modulatory signal,決定已被標記的突觸是否被放大、削弱,或改變 STDP 的 polarity。這比「dopamine 讓所有突觸變強」精確得多:只有留下 eligibility 的突觸才有資格被影響,而且實際方向還取決於 receptor、細胞類型、局部 calcium/voltage 狀態、活動時序與所處的 basal ganglia pathway。Frémaux 與 Gerstner 對 three-factor learning rules 的整理特別強調,neuromodulator 既可能 gate plasticity,也可能影響 plasticity 的方向。
這個方案的優點是時間範圍很大、訊號可以廣泛投射。同一個 reward 可以影響許多 target circuit,讓神經系統不必替每一顆突觸拉一條專用的 error wire。
但「廣泛投射」不等於所有 dopamine neurons 都廣播同一個 scalar。不同 dopamine neuron、axon terminal 與 target circuit 可以呈現不同的 reward、movement 或 feature-related response;Lee 等人的 2024 年 computational model說明 feature-specific prediction error 如何解釋既有的 dopamine response 異質性。即使如此,dopamine 仍無法單獨說明深層網路裡每個 neuron 應該怎麼改。eligibility trace 提供突觸局部線索,receptor、局部電位、dendritic compartment 與 circuit pathway 再做更細的選擇。
因此,dopamine 最適合被理解成一族可廣泛投射、但具有 target-specific 結構的 neuromodulatory signals,不是完整的逐突觸梯度。某些通道攜帶有正負的 reward prediction error;feature-specific RPE 或 action prediction error 也可能提供特定 feature/action dimension 的方向。unsigned salience 比較接近 gain/gating,而 movement-correlated activity 是否真是 teaching signal,必須靠模型與因果實驗另外辨識。
局部誤差:為 neuron 提供修正方向與幅度
如果 dopamine 比較像「這次結果好不好」,error feedback 則更接近「這個 neuron 的輸出往哪裡偏了」。在工程式寫法中,局部突觸更新通常長得像:
是 presynaptic activity, 是指向 neuron 的 error 或 teaching signal。這個 若有正負號,就能告訴突觸增加或減少對輸出的貢獻。
但在神經系統裡, 不是一條固定來源的「error 電線」,而是不同迴路對同一個功能問題的抽象名稱。它可能來自幾個地方:
- 輸出結果與目標的差:在人工網路裡,output loss derivative 可經由 backward pathway 轉成 hidden neuron 的 。在 feedback alignment 中,這個轉換可示意成 ; 是 output-gradient vector, 是 feedback matrix,所以它是模型假設的 teaching signal,不是直接觀察到的腦內量。
- 感覺/動作 prediction error:小腦的 climbing fiber 可以把 retinal slip 或其他 motor-performance error 傳到 Purkinje cell,讓局部可塑性知道預測或動作偏在哪裡。Kimpo 等人的 VOR 實驗顯示,這個訊號的學習效果還會受到任務與迴路狀態調節。
- reward prediction error:在 basal ganglia 等獎勵迴路,dopamine 的 phasic activity 可以提供「結果比預期好或壞」的方向,但通常比較像廣域的調節量,還要和 eligibility trace、receptor 及局部活動結合,才會變成特定突觸的更新。
- 局部 dendritic mismatch:apical dendrite 收到的 top-down、context 或 error-related input,和 basal/somatic activity 的差異,可以在 neuron 內部形成 teaching state。這是 dendritic learning 嘗試把跨區域訊號轉成局部可讀量的方式。
- local prediction error:predictive coding 在每一層建立 prediction 與目前 activity 的 mismatch,讓每個區域都有自己的 error-like signal;它不是從單一 output neuron 把一個 完整倒傳回來。
所以要分清楚三種符號:output 的 是「最後結果錯多少」;hidden neuron 的 是「對這個 neuron 而言,應該往哪個方向修」;突觸上的 則保存「這條突觸近期的局部活動與輸出敏感度」。它們常常被放在同一個更新式裡,但不是同一種物理量。
大腦知道哪一步錯了嗎?答案是:有不同解析度
你的直覺是對的:如果訊號只有一個全腦廣播的「成功/失敗」,它通常只能告訴整條行為鏈的結果,不能直接告訴每一個中間步驟該怎麼改。這正是 distal credit-assignment problem 的核心。
但「知道哪一步」不是只有知道或不知道兩種狀態,而有解析度差異:
- 整條鏈路解析度:dopamine 等廣域 reward prediction error 可以表示結果比預期好或壞。它適合回答「這次行為值得重複嗎」,但通常不能單獨指出是觀察、決策、動作的哪一個環節出錯。
- 子系統/任務解析度:小腦收到 motor-performance error,視覺系統收到 sensory mismatch,這些訊號已經比全域 reward 更接近「是哪一類能力出問題」,但仍不等於整個網路每個突觸的精確梯度。
- neuron 解析度:不同 neuron 可能因為在任務中扮演不同角色,而收到方向相反或幅度不同的 teaching signal。Francioni 等人的 2026 年 Nature 研究在 6 隻小鼠的 retrosplenial cortex 成像 cohort 中,以 experimenter-defined reward function 的 neurofeedback BCI 任務觀察 layer-5 pyramidal neurons。somato-dendritic residual 呈現和 neuron causal role 相關、帶符號的 error-derivative pattern;另一個 4 隻小鼠 cohort 中,對 layer-1 NDNF-positive interneurons 的 optogenetic intervention 使正常學習受損。這支持 layer-1/apical dendritic computation 對學習具有因果重要性,但 intervention 同時降低 somatic event frequency,並非只選擇性移除 residual,因此不能把行為缺損唯一歸因於某個 vectorized teaching component。作者也無法完全區分它是驅動 synaptic change 的 teaching signal,還是執行任務時的 online control/computation signal,更不等於已證明一般皮質使用完整的 synapse-by-synapse backpropagation。
- 突觸解析度:局部突觸可以保留帶有時間結構的 eligibility state,再由局部狀態與 teaching signal 組合出更新。它不只圈出候選集合,也可能依 timing 或 local sensitivity 對突觸加權;但它仍不保證得到對全域任務唯一正確的 credit。
因此,生物系統可能不是先計算「第 37 個突觸對最後 loss 的精確偏導數」,再把它送回去。不少候選模型改用腦區分工、感覺/動作誤差、樹突 compartment、時間痕跡和反覆試驗,逐步把 blame assignment 做到足夠有用的精度;這構成一種近似、分層 credit assignment 的候選圖景,不是已證實的 textbook BP。
子系統誤差從哪裡來?不是由全域結果自動分解
全域 reward 本身不包含「視覺錯 20%、動作錯 80%」這種分解。更重要的是,sensory error 與 motor error 通常不是從 reward 拆出來的:它們各自有不同的 observation、prediction、reference signal 或 forward model。神經系統要得到子系統誤差,必須先有這些可比較的中間變數。
可以用三步理解:
- 不同結果流進不同 comparator:reward 進入 value comparator;感覺輸入和 sensory prediction 比較;動作的實際後果和 efference copy/forward-model prediction 比較。
- 各 comparator 產生自己的 mismatch:形成 、、 或其他 local prediction error。
- 局部 teaching signal 和 eligibility 結合:mismatch 再透過 pathway、dendrite 和 eligibility trace,影響該子系統內具有局部敏感度的突觸。
用簡化流程表示:
reward r_t + value prediction             → δ_reward
sensory observation + sensory prediction  → ε_sensory
motor outcome + forward-model prediction  → ε_motor
top-down target/context + local state      → ε_k
                                                │
local eligibility / sensitivity ────────────────┘ → local Δw
在 reward learning 裡,critic 可以估計某個狀態或動作的 value,形成類似 temporal-difference error 的量:
這個 仍然主要是 value 層級的誤差,不是每個皮質突觸的 blame。中腦 dopamine 的 prediction-error 計算本身也需要局部迴路,例如 VTA 的 GABAergic neurons 提供與 reward expectation 有關的抑制訊號,協助 dopamine neurons 做差值計算。Eshel 等人的研究提供了這種「全域結果先經過局部 circuit arithmetic」的例子。
在 motor learning 裡,子系統誤差更直接:小腦可以用 forward model 預測動作的 sensory consequence,再和實際視覺/本體感覺回饋比較,形成 sensory prediction error。Streng、Popa 與 Ebner的研究把 Purkinje-cell activity 與這種預測和回饋的時間關係連起來。這時大腦不是從「任務失敗」硬猜哪一步錯,而是利用 motor circuit 自己知道的中間變數,先產生一個較局部的誤差。
所以,global-to-local 的關鍵不是一個神奇的 error splitter。在這個 comparator abstraction 裡,要產生可用的子系統誤差,需要某種可比較的 prediction、reference 或 target representation,以及和該子系統相關的結果資訊。沒有這些中間表示,單一 scalar reward 很難可靠指出是哪個步驟造成失敗。
小腦常被視為 supervised-like learning 的經典神經迴路之一。Purkinje cell 接收 mossy/parallel fiber 的輸入,也接收 climbing fiber 的 instructive signal;在 vestibulo-ocular reflex(VOR,前庭眼反射)等任務中,climbing fiber activity 可以反映 retinal slip 這類動作表現誤差。Kimpo 等人的研究更進一步顯示,同樣強的疑似 error signal,在不同訓練範式中對學習的作用並不相同:某些情況下可以預測下一次輸出改變,甚至用 optogenetic activation 寫入 motor memory;另一些情況則不行。
這個結果很值得記住,因為它阻止我們把「有 error signal」直接等同於「已經有完整 learning algorithm」。error 必須和正確的活動、時序、細胞與可塑性路徑配對。否則它可能只是相關性很高的旁觀者。
訊號定位的硬體:dendritic signal 如何進入局部 plasticity
單一 scalar neuron 很難同時接收前向活動與高階 teaching signal。真實的 pyramidal neuron 有 soma、basal dendrite、apical dendrite 等不同 compartment,這提供一個硬體上的可能性:
- basal dendrite 接收感覺或 feedforward activity;
- apical dendrite 接收 top-down、context 或 error-related input;
- soma 與 dendritic calcium/burst state 的組合,決定這次 synapse 是否應改變。
dendritic compartment 是訊號定位的候選 substrate,不是和 NGRAD、feedback alignment 互斥的另一套演算法;不同模型可以用它承載 activity difference、cell-specific feedback 或 neuromodulatory gating。
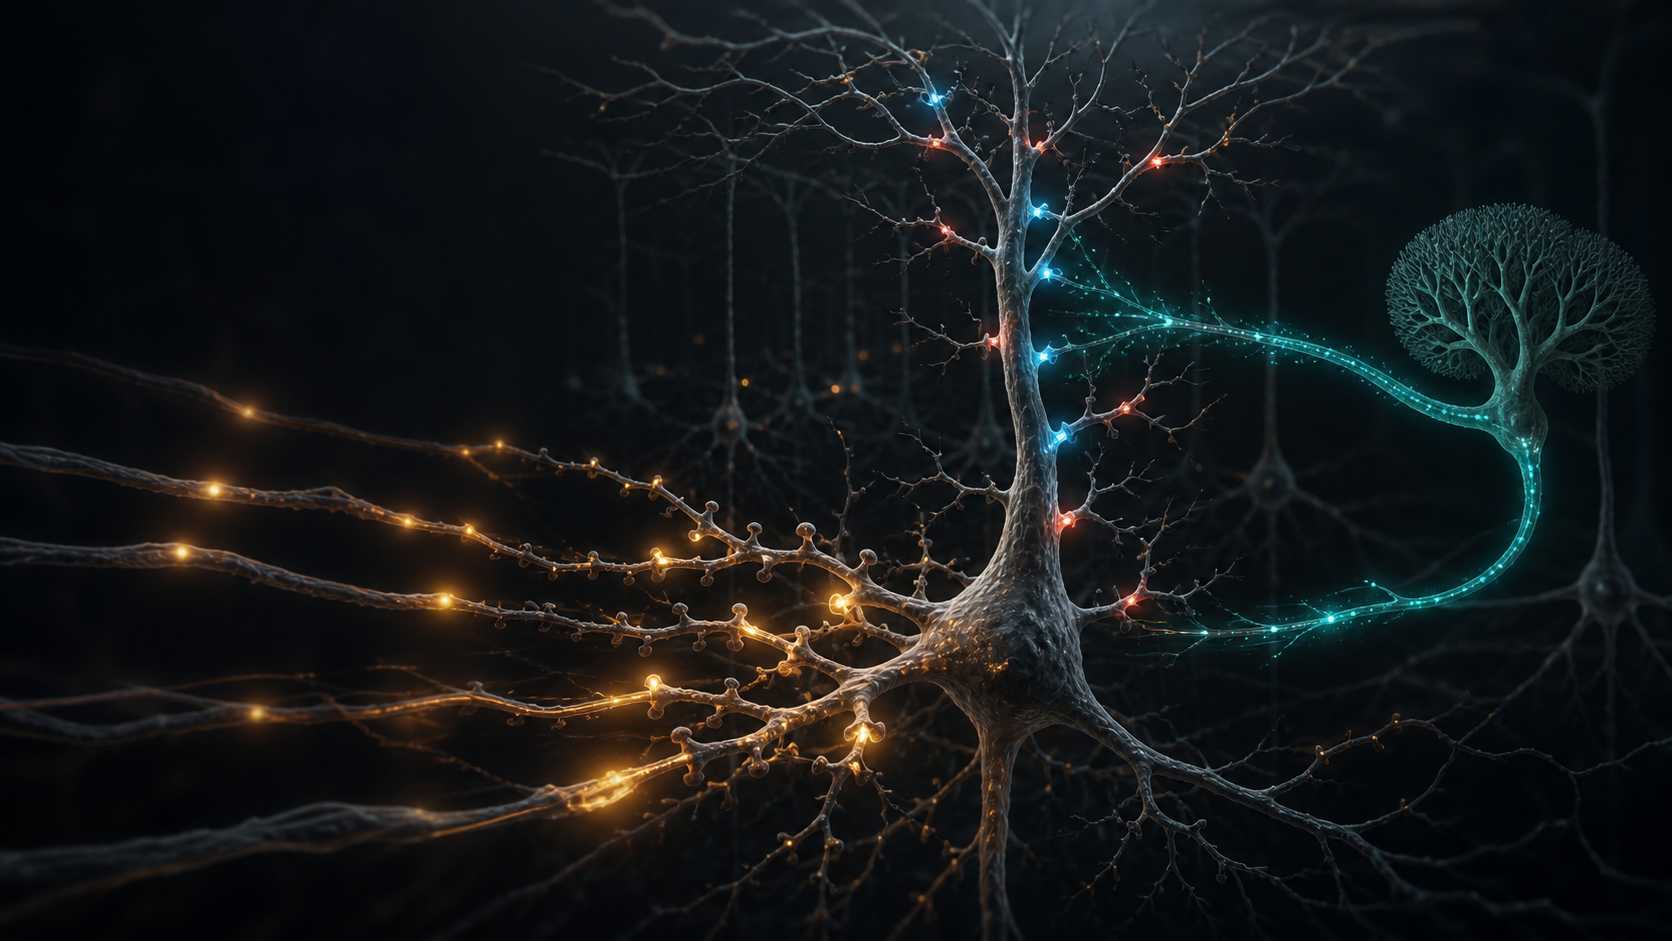
怎麼讀這張圖: 橘色訊號代表 basal dendrite 收到的前向/感覺活動,藍色訊號代表 apical dendrite 收到的高階 feedback 或 teaching signal;兩者不必先被壓成同一個 scalar,而是在 soma 與樹突的電位、calcium、burst state 中互動。最後,局部可塑性規則把「突觸最近看到了什麼」和「這次應該往哪裡改」合在一起,產生 。這是一個生物硬體上的可能架構,不是所有皮質神經元都固定遵守的接線圖。
先看 basal dendrite:它比較像「目前輸入正在說什麼」
在許多新皮質的 pyramidal neuron 裡,basal dendrites 從 soma 附近向側面展開,接收的突觸通常來自較低階的皮質區域、局部皮質迴路或 thalamocortical feedforward pathway。以視覺皮質的簡化圖像來說,外界刺激先經過 V1 的 layer 4,再把局部特徵送到上層 pyramidal neuron 的 basal tree;V1 的研究把 basal dendrites 描述為主要接收 feedforward input,而 apical dendrites 較多接收 cortico-cortical feedback。
這裡的「接收」不是把訊號原封不動搬到 soma。每個 basal branch 都像一個小型的局部積分器:附近的 synapse 產生 excitatory postsynaptic potentials(EPSPs),這些電位在樹突上相加、互相抵消,也可能透過 NMDA spikes 等非線性事件放大。因為 basal tree 通常比 apical tuft 更靠近 soma,basal activity 比較容易直接影響 soma 是否達到 action-potential threshold;工程上可以把它看成主要提供「當下這個 neuron 應該對什麼刺激有反應」的 bottom-up evidence。
但 basal 不是單純的「輸入電線」。它同樣受到 local inhibition、branch-specific calcium dynamics、back-propagating action potentials 和 synaptic plasticity 的影響;同一個感覺輸入,在不同網路狀態下可能得到不同輸出。甚至在不同皮質區、不同 layer 或不同 cell type,basal tree 的輸入來源也會變化。這就是為什麼文章裡用「主要接收」而不是「只接收」。
再看 apical dendrite:它比較像「這個輸入應該如何被解讀」
大型 layer 5 pyramidal neuron 的 apical dendrite 從 soma 向上延伸,最後在 layer 1 形成 distal apical tuft。這個區域可以接收來自高階皮質、長程 corticocortical pathway、higher-order thalamus、局部 layer 1 circuit 和 neuromodulatory system 的輸入。Layer 1 的綜述指出,top-down information 大量匯入 layer 1,而 layer 2/3 與 layer 5 pyramidal cells 用不同的 dendritic compartments 整合 bottom-up 與 top-down stream。
因此 apical signal 的直覺不是「另一份感覺資料」,而是 context、prediction、attention、task state 或 teaching signal,例如:
- 「目前看到的線條,在這個情境下應該被解讀成什麼?」
- 「這個 neuron 的輸出對高階目標是有幫助還是有害?」
- 「在這次任務與行為狀態下,這個 basal pattern 值不值得被放大?」
apical input 的一個反直覺特性是:它離 soma 很遠,單獨產生的電位可能會在傳到 soma 的途中衰減。因此,apical input 不一定直接讓 neuron 像收到強感覺刺激那樣放電;它常常先改變 soma 對 basal input 的 gain、threshold 或 burst probability。這使它適合扮演「調制」或「教學」角色,而不只是第二條 feedforward pathway。
這個想法有明確的生理基礎:apical dendrite 具有 voltage-gated calcium channels;當 distal dendritic depolarization 和由 soma 往回傳的 action potential 在合適時間窗重合,可能產生 dendritic calcium spike/plateau,進一步把 soma 從單發 spike 推向 high-frequency burst。Larkum、Zhu 與 Sakmann 的研究是這條研究路線的經典起點;後續的生理與多 compartment model 也顯示,basal 與 apical input 的 coincidence 可以控制 layer 5 neuron 的 burst output。Shai 等人
兩條輸入為什麼要分開?因為「有活動」和「活動是否符合上下文」是不同問題
假設只有一個 scalar neuron,所有輸入都先加總成 。它可以知道目前收到多少活動,卻很難在同一時間區分:哪些是 bottom-up evidence,哪些是「這個 evidence 在目前 context 下是否應該被接受」的訊號。
有了 basal/apical separation,neuron 可以實現一個更有結構的判斷:
在 learning 的語言裡,basal synapse 提供「我剛才參與了什麼活動」,apical state 提供「這個活動在高階任務中應該被鼓勵、抑制或重新解讀」。於是局部 plasticity 可以近似:
這不是說 apical dendrite 裡真的有一個寫著 error 的數字,而是說 apical 的電壓、calcium、plateau 或 burst-related state,可能成為突觸可讀取的第三個條件。這正是 dendritic learning 想解決的問題:把跨區域的方向性訊號,轉成同一顆 neuron 內局部 plasticity 能使用的狀態。
這個對應不是鐵律
「basal=feedforward、apical=feedback」是一個非常有用的第一張圖,但不是所有 pyramidal neurons 或所有 cortical areas 的完整接線圖。apical dendrites 也能接收 thalamic、local、neuromodulatory 或 sensory-related input;basal dendrites 也可能收到 feedback 或 recurrent input。甚至在 mouse V1 的一項實驗中,切除 apical tuft 對 orientation tuning 的影響很小,表示「有 feedback input」和「該 input 對某一項表徵是必要的」是兩件事。該研究
因此,最負責任的讀法是:basal 與 apical 是兩個在空間上部分分離、可以執行不同時間與非線性運算的輸入域;它們常常對應 bottom-up 與 top-down,但不能直接把解剖位置等同於 error、prediction 或 gradient。
在這種想法下,局部 rule 可以寫成一個不承諾特定細節的形式:
真正的 teaching state 可能是 apical–basal voltage difference、dendritic plateau、calcium transient、burst probability,或其組合。這也是為什麼「dendritic learning」不是單一演算法,而是一整類把非局部資訊轉成局部可讀狀態的模型。
Guerguiev、Lillicrap 與 Richards 的 segregated-dendrite 模型把 feedforward 與 feedback/target input 放在不同樹突 compartment,讓 neuron 能用局部狀態差產生 learning signal。Payeur 等人的 burst-dependent plasticity 模型則利用 apical dendritic regenerative activity、feedback pathway 與 burst-dependent plasticity,在模擬與數學分析中處理階層網路的 credit assignment。
這裡的「方向性」比 dopamine 更局部、更有機會對準特定 neuron;代價是需要一套可信的解剖連線、樹突整合與可塑性時序。模型能跑通,不代表活體皮質已經被證明使用同一套 compartment rule。
一個較新的實驗方向,是直接問 apical dendrite 收到的是不是同一個 scalar error。2026 年一篇 Nature 研究以 cell-specific causal roles 為設計,報告與「vectorized instructive signals」一致的 dendritic activity:不同 neuron 可能收到方向不同、和自身任務角色相關的 signal。這項研究讓 不再只是數學上的第 個分量,而成為一個可以被實驗檢驗的問題;但其 teaching-versus-online-computation interpretation 尚未封閉,也仍未證明完整的跨區域 learning rule。
網路層級的方向:NGRAD 框架與 feedback transport
前四節比較接近突觸與神經元的硬體問題。接下來改看網路層級:跨多層 circuit 的 teaching signal 怎麼形成?這裡不是三個互斥選項。NGRAD 是以 activity differences 表示 gradient-like information 的上位框架;dendritic learning 與部分 predictive-coding models 都可能是它的實作方式。Feedback alignment(FA)則是另一族方法,直接近似跨層 error transport。
NGRAD:用活動差異表示方向
Neural GRADient representation by Activity Differences(NGRAD,以神經活動差異表徵梯度)不是一個固定的單一演算法,而是 Lillicrap 等人在 2020 年的 perspective 用來整理一組候選機制的名稱。activity difference 可以來自不同時間 phase、不同 neuron population,或同一顆 neuron 的不同 dendritic compartments;predictive-coding-inspired local differences 也在這個家族裡。
它的核心直覺是:不要要求大腦明確傳送一個精確的 gradient vector;讓 feedback、target 或另一個 network state 把局部活動推向另一個狀態,兩者之間的差異扮演 error-like signal。
在 presynaptic state 近似固定、只把 postsynaptic target difference 當成 local teaching signal 的最簡特例裡,可以寫成:
這條式子逐項怎麼讀?
先提醒一個記號慣例:因為右側是向量的外積,左側通常更嚴謹地寫成 ,大寫 表示整層的 weight matrix;如果只看單一突觸,才寫成 。這裡採用「第 層的權重把 連到 」的索引方向。
- :layer index。 是前一層活動, 是目前這一層活動。
- :只靠正常 bottom-up/feedforward input 算出來的 activity。它回答:「如果沒有額外 teaching influence,這一層目前會呈現什麼狀態?」
- :在高階 feedback、target 或 output error 影響下,被輕微推動後的 activity。
nudged的意思不是把 neuron 強行設定成正確答案,而是讓它朝「如果結果要更好,這一層可能應該接近的狀態」移動一點。 - :兩種狀態的差,記成 。它是這條示意規則裡的 local error-like/teaching signal:正值表示某個 unit 應增加活動或權重的影響,負值表示應減少;實際正負仍取決於模型的定義與更新目標。
- :前一層活動的 transpose。它代表每條 incoming synapse 的 presynaptic activity,因為「要改哪條突觸」必須知道那條突觸最近收到多少輸入。
- :表示「成正比」,省略了 learning rate、activation derivative、normalization 或其他模型細節。最簡版可以寫成 。這不是所有 NGRAD 的通式;equilibrium/contrastive 類方法可能比較兩個 phase 的 pre–post correlation,而不只是「postsynaptic difference × 固定 presynaptic activity」。
為什麼要做外積?假設 有 個 neuron,而 有 個 neuron:
因此,矩陣中的單一元素是:
怎麼讀這張圖: 左邊的兩個 teaching signal 是矩陣的兩列;上方的兩個 presynaptic activity 是矩陣的兩欄;四個格子就是四條可能的突觸。每一格都等於「該列 neuron 的方向 × 該欄 neuron 的活動」,所以它同時回答「往哪裡改」與「哪條連線最近有資格被改」。
它的意思很直觀:第 個 presynaptic neuron 如果很活躍,而第 個 postsynaptic neuron 又被 feedback 推向更高的活動,連線 就傾向增加;如果差值為負,則傾向減少。若 ,即使第 個 neuron 收到 teaching signal,這條沒有活動的 incoming synapse 也不會因這條規則得到同樣的更新。
這個公式和標準 BP 的外觀很像:都是「post-like error signal × pre-synaptic activity」。真正的差異在於第一項從哪裡來。BP 使用 loss 對 hidden state 的精確導數;NGRAD 類示意式則使用兩個神經活動狀態的差,期待在特定 feedback、nudging、equilibrium 或 inverse-mapping 條件下,這個差能提供足夠有用的方向。它是方向的近似,不是已證明的逐突觸梯度。
因此,這條式子要分三個層級讀:
- 演算法假說:如果網路用「活動差 × 前一層活動」更新權重,它能不能完成某個學習任務?這可以用人工神經網路或 spiking model 測試。
- 機制模型:真實 neuron 是否有可能用 basal/apical voltage、calcium、burst 或 neuromodulator,近似產生公式中的兩個因子?這需要和生理與解剖資料比較。
- 生物學事實:活體大腦是否真的以這個精確公式更新每條突觸?目前沒有這樣的完整證據。
所以答案是:它是在猜測一類可能的神經學習規則,而且是受生物結構限制約束的猜測;不是已經證明神經細胞實際執行的公式。其中「前後兩種活動狀態的差」可能有 dendritic、feedback 或 error-related 生理對應,但「恰好用這個外積更新所有突觸」仍是模型化抽象。
它把方向表示成兩種 activity state 的差,而不是顯式存放一個 gradient object;但這個差仍可能依賴 feedback wiring、互惠連線、nudging 或 learned inverse。它可以和 eligibility trace 結合:活動差先變成 local teaching state,真正的更新可以延後到 neuromodulatory signal 到達。
NGRAD 的優點是把「大腦可能用活動差異而非顯式梯度」這個研究問題說清楚;限制是它比較像一張地圖。gradient-like quantity 可以用 activity difference 表示,但這個 difference 如何由 feedback 形成、是否需要互惠或近似對稱的連線,以及是否和 true gradient 對齊,仍由各模型另外假設。不同 NGRAD 候選模型對 feedback、phase、equilibrium、inverse mapping 與 compartment 的要求不同,不能把 NGRAD 當成已驗證的 cortex learning rule,也不能假設 activity difference 自動解決 feedback transport。
Feedback alignment:方向可以近似,不必精確 transport
若把 定義為 loss 對第 層 pre-activation 的導數,標準 backprop 在 hidden layer 使用 forward weight 的 transpose,並乘上 activation derivative:
Feedback alignment(FA)改用固定或隨機的 feedback matrix :
其中 是 element-wise product。若某個簡化例子假設 linear activation,或把 吸收到 的定義裡,才可以省略這一項。本文沿用「 是 pre-activation gradient」的慣例。
Feedback matrix 和 error vector 到底是什麼?
這裡最容易混淆的是: 不是 neuron 本身的 activity, 也不是正常的 forward weight。
- :第 層的 error/teaching vector。它的每個分量回答:「第 層的這個 neuron,輸出應該往哪個方向、改多少,才比較有機會降低 loss?」在輸出層,它通常可以由 target 與 prediction 的差得到;在 hidden layer,它則是由更高層的 error 傳回來的近似量。
- :feedback matrix。它把第 層的 error vector 轉換成第 層每個 neuron 可用的 error/teaching signal。 的每個元素不是「第 個 neuron 的活動」,而是「第 層的 error 應該以多大權重影響第 層某個 neuron」。
- :用 feedback alignment 算出來的第 層近似 error vector;上標
FA只是標記「這不是標準 BP 的精確 」。
假設第 層有 個 neuron,第 層有 個 neuron,那麼:
因此 的結果是 維,剛好能給第 層每個 neuron 一個方向。為了只示範 feedback mixing,下面先假設 :
第一個 hidden neuron 收到正方向 ,第二個收到負方向 。這不是說它們「知道完整 loss 對自己的精確偏導數」,而是透過 把高層 error 混合成一個可用的近似方向。
生物真的在做矩陣乘法嗎?
不一定。矩陣是我們描述大量平行突觸連線的語言,不是神經元裡真的有一個矩陣物件。把矩陣乘法拆成單一 neuron 的版本,就會變成:
第一式是 feedback drive,第二式才是包含 local activation derivative 的完整 FA error。它的生物直覺是:第 層的 neuron 收到來自第 層很多 neuron 的 feedback;每條 feedback connection 有自己的強度 ,而上游 neuron 的活動或 teaching-related signal 提供輸入;neuron 把這些輸入整合起來,再由自己的局部 excitability/gain 調節。所有 neuron 同時做這件事,在族群層級寫起來就像 。
可以用這個對應來讀:
| 數學寫法 | 可能的生物對應 |
|---|---|
| 第 層第 個 neuron 的活動、burst、calcium 或其他 error-related signal | |
| 從上游 neuron 到下游 neuron 的 feedback connection 強度與符號 | |
| postsynaptic neuron 對許多突觸輸入的電流/電位整合 | |
| neuron 得到的局部 teaching-related state |
因此,生物不需要先知道「第 列、第 欄」;它只需要讓每條軸突—突觸連線攜帶訊號,讓 postsynaptic neuron 在 soma 或 dendrite 把輸入整合。矩陣的列與欄,是研究者把這些連線全部列出來後的索引方式。
不過這只是可能的計算對應,不是 FA 已經被證明存在於大腦的證據。還有兩個不能跳過的 biological constraints。第一,spike count 與 firing rate 天生非負,帶正負的 需要用 baseline-relative firing、opponent populations、burst code 或其他機制表示。第二,任意正負的 不自然地符合 Dale's law;實作通常需要把正負路徑拆成 excitatory neuron 與 inhibitory interneuron circuit。FA 模型中的 fixed/random 是工程假設,真實 feedback projection 可能有結構、可塑、受 neuromodulator 調節,dendritic integration 也可能非線性。segregated-dendrite 模型也把 cell-specific signed signal 的傳遞列為核心難題。
最謹慎的說法是:神經組織確實能透過平行突觸輸入產生類似加權和的運算,但目前沒有證據說大腦真的以 FA 方程式中的固定隨機矩陣傳遞 error。
它和 BP 的差別: BP 使用 ,也就是 forward pathway 的權重轉置;FA 使用另一個固定或隨機初始化的 。FA 的研究結果顯示,forward weights 在學習過程中可能逐漸調整,讓這個不精確的 feedback 方向仍然有用;但 本身不是因此就變成了真正的 ,也不能直接解讀成大腦裡已被證實的隨機 error wire。
突觸更新仍可以寫成 。Lillicrap 等人的 2016 年研究顯示,在人工深度網路裡,forward weights 會逐漸調整,使固定 random feedback 產生的方向變得有用;它不需要完全重建 。
FA 解決的是跨層方向怎麼近似傳回去,不是延遲回饋的時間記憶。它可以和 eligibility trace 結合,也可以和 dendritic compartment 結合;但「人工網路能用 random feedback 學習」不等於「皮質使用固定隨機 feedback」。這是 proof of possibility,不是 biological evidence。
NGRAD 的一條路:Predictive coding 的 local mismatch
Predictive coding 不把 feedback 定義成一次性的 backward pass,而是讓高層產生 prediction,低層比較 prediction 與自身狀態,再把 mismatch 表示成 prediction error:
這三個符號可以先當成「實際值 − 預測值」來讀:
- :第 層的 prediction error,亦即 mismatch。它告訴系統「目前收到的狀態和原本預期差多少」,所以有大小也有方向。
- :第 層目前真正的 activity。它可能是感覺輸入、某一群 neuron 的 firing rate,或模型中的 hidden-state vector。
- :第 層的 predicted activity;帽子 表示「估計/預測」,通常由較高層的 representation、context 或 generative pathway 產生。
- 下標 :表示這是第 層自己的局部誤差,不一定是從 output layer 一次倒傳回來的全域 error。
例如,如果某一個 unit 的實際 activity 是 ,預測是 ,那麼:
正號表示實際活動比預測高;如果實際值只有 ,則 ,表示實際活動低於預測。若第 層有很多 neuron,這些量會一起寫成向量,例如 ,每個分量對應一個局部 mismatch。
要注意, 首先是「哪裡預測錯了」的訊號,不必然等於標準 BP 的 gradient,也不自動表示某條突觸該增加或減少多少;還需要搭配局部 synaptic rule、presynaptic activity、precision 或 neuromodulatory signal,才會形成實際的權重更新。在 spiking implementation 裡,正負 同樣需要 baseline-relative code 或 opponent error populations,不能直接把 signed scalar 當成一條只有非負 firing rate 的 wire。
其中 是第 層目前的 activity, 是由更高層 prediction 產生的估計。局部網路透過更新 neural state,降低整體 prediction error;synaptic rule 則在特定架構下使用 local error 與 presynaptic activity。
Whittington 與 Bogacz 的模型展示,在特定 predictive-coding network、local Hebbian plasticity 與推論條件下,更新可以近似 backpropagation。這是一個數學上的橋:如果 prediction、error unit、precision、inference dynamics 與 equilibrium 假設成立,local prediction errors 可以攜帶有用的方向。
但 prediction error 不等於 eligibility trace,也不自動等於 gradient。predictive coding 主要解決「網路如何持續表示 mismatch」,eligibility trace 解決「延遲後如何找回曾參與的突觸」。時間任務中,兩者可以同時存在。
把這些名詞放回同一張圖
到這裡可以用三個問題讀任何一篇 biologically plausible learning paper:
它如何保存局部影響?看有沒有 pre/post activity、STDP、dendritic calcium、burst state 或 eligibility trace,以及這些 state 保存的是 correlation、timing,還是具有 derivative 意義的 synapse-specific sensitivity。
它如何知道往哪裡改?看 teaching signal 是否有符號、是否表達 prediction error、reward prediction error、motor error 或 target difference。
它如何找到正確突觸?看 feedback 是全域廣播、隨機矩陣、局部 compartment、cell-specific dendritic input,還是由 recurrent circuit 自己形成。
因此,這些名詞不是同一層級的七個選項:
- eligibility trace 保存延遲後仍可使用的 synapse-specific local state;在 e-prop 等特例中,它具有 local sensitivity 的精確定義;
- dopamine 與其他 neuromodulator 提供 task-level modulation、valenced prediction error 或 plasticity gate,但投射並非全然 homogeneous;
- cerebellar error feedback 提供特定 motor circuit 的 instructive correction;
- NGRAD 是用 activity differences 表示 gradient-like information 的上位框架;dendritic difference 與部分 predictive-coding models 都可能屬於這個框架;
- feedback alignment 用不精確的 feedback pathway 近似跨層方向,屬於不同但可組合的 error-transport family。
它們可以疊加。一種常見、可測試的組合假說是:dendritic or local error 提供 neuron-level 方向,eligibility trace 保存時間證據,neuromodulator 決定是否值得學,homeostatic plasticity 維持網路穩定。
哪些已經被證實?
這裡要把三種「證實」分開:
- 生物零件存在:突觸可塑性、dopamine modulation、dendritic calcium、cerebellar climbing fibers 等,有大量實驗研究支持。
- 演算法可以工作:e-prop、feedback alignment、predictive-coding models、dendritic models 在特定任務和假設下可以學習。
- 大腦真的用這套完整規則:目前沒有哪一套已經完成從跨區域訊號、局部突觸更新到行為改善的完整因果驗證。
最穩妥的結論是:方向性學習的生物學零件已經相當多,但完整 wiring diagram 與 learning rule 仍未封閉。NGRAD、feedback alignment、predictive coding 和 dendritic learning 的價值,不是宣布哪一個已經勝出,而是把「方向如何抵達局部突觸」拆成可測試的不同假說。
給 AI 工程師的最小模型
如果要在 neuromorphic agent 或 spiking network 裡實作這個想法,先不要從「如何重造 BP」開始,先回答四個問題。下面給的是可以寫成 code 或 neuromorphic state machine 的兩個 baseline:有逐時 target 的 supervised/broadcast-alignment 版,以及只有 reward 的 actor–critic 版。它們共用局部 eligibility,但 teaching loop 不應混成同一條公式。
1. 局部突觸可讀到哪些 activity?
最小可行集合是 presynaptic spike trace、postsynaptic membrane/spike state、這條 synapse 自己的 weight,以及 postsynaptic neuron 可局部計算的 excitability。它不應讀取別層的 weight matrix,也不應直接查詢其他 synapse 的內部狀態。
可以先為每個 presynaptic neuron 保存低通 spike trace:
其中 是當下是否放電, 是近期 presynaptic activity。postsynaptic factor 用 表示;在簡單 LIF neuron 裡,它可以是 spike threshold 附近的 surrogate derivative。最小 LIF-style eligibility 可寫成:
這裡 是 local excitability/surrogate derivative,不是 teaching signal。若 apical dendrite 帶有 feedback state,應另記成 或納入 ,避免把 teaching signal 同時塞進 與 而 double count。若 neuron 有 adaptation、recurrent hidden state 或 multi-compartment dynamics,完整 e-prop eligibility 還要包含這些 local state 的 Jacobian/recurrence;上式只是簡單 LIF baseline,不是所有 neuron model 的通式。
2. 哪個訊號提供 update 的 sign 與 magnitude?
最終 sign 與 magnitude 不是由單一訊號決定,而是 task-level/neuron-level learning signal 和 synapse-level eligibility 的乘積:
若輸出層有 target,一般情況先算 loss 對 output pre-activation 的導數:
再把 output-gradient vector 經固定 feedback projection 傳給 hidden neuron:
在初始化時抽樣一次、做尺度正規化,之後固定。這是 fixed-random output-to-hidden broadcast,也可稱 direct feedback alignment/broadcast alignment baseline;它不是前面逐層傳遞 error 的 vanilla FA。只有在 linear readout + squared error,或 softmax–cross-entropy 對 logits 的相容表示下, 才能簡化成 prediction minus target。若換了 output activation 或 loss,不能照抄 。
若任務只有 reward、沒有 supervised target,critic 可產生 temporal-difference error:
但 scalar 只提供 task-level valence。actor 還需要 neuron-specific policy/action factor ,例如由 action readout pathway 近似 。最後的 synaptic credit 由 、 與 共同形成,而不是把 TD error 直接當成所有 hidden neuron 的方向。
3. 延遲回饋來時,如何找到幾百毫秒前的 eligibility?
先區分兩件事。對 e-prop,eligibility dynamics 應由 postsynaptic neuron 的 state dynamics 導出;簡單 LIF 的基本項就是前一題的 ,不能任意再加一層低通就宣稱是 exact e-prop。對 generic delayed-feedback baseline,則可以在 local eligibility 外再維持一條明確標記為工程近似的 delay trace:
對 supervised event feedback, 尚未抵達時設為 0,trace 繼續演化但不更新 weight;feedback 抵達時才用 。 可以先依 feedback-delay distribution 選工程初值,再用 retained trace strength 與 ablation 校準。過短會在 feedback 抵達前消失;過長會把太多無關事件混在一起。若 delay 很寬,可以並行使用多個 log-spaced time constants,而不是只押一條 exponential trace。
reward-based actor–critic 則應把 neuron-specific policy factor 也存進 policy eligibility:
這個額外 trace 表示「這條 synapse 經由 neuron/policy pathway,近期如何影響已採取的 action」。它允許 online approximate update 而不用重播整段 spike history,但一般不等於完整 BPTT gradient。對真正的 e-prop 實作, 與 的 recurrence 應依選定的 neuron、readout 與 policy parameterization 推導,不應只按 reward delay 猜一個 。
4. teaching signal 應該用哪一種 topology?
答案取決於任務可取得哪種 feedback:
- 有逐時 target 的 supervised 任務:先用 fixed-random、normalized、cell-specific output broadcast。也就是 output-gradient vector 經抽樣一次後固定的 ,混成每顆 hidden neuron 不同的 。它比單一 scalar 多了 neuron-level direction,又不需要 transport 精確的 forward weights。
- 只有 reward 的 agent:用 actor–critic 的 scalar TD error gate policy eligibility;neuron-specific credit 來自 action/policy readout pathway ,不能只把同一個 廣播給所有 hidden unit。
- multi-compartment hardware:可以把 supervised 或 policy-related feedback 路由到 apical/teaching compartment,讓 basal synapse 只讀 feedforward activity,apical state 提供 neuron-specific modulation。
若硬體遵守 Dale's law,signed 要拆成正負/opponent pathways;也要正規化 的 row norm,避免 output dimension 增加時 teaching magnitude 一起爆掉。真正的比較至少應包含 scalar broadcast、fixed random cell-specific、learned cell-specific,以及 compartment-specific 四個 ablation。
把四題合起來,兩條最小 online loop 應分開寫。Supervised/broadcast-alignment baseline:
every timestep:
  zbar_j ← α_z zbar_j + spike_j
  e_ij   ← ψ_i zbar_j
  etilde_ij ← λ_d etilde_ij + e_ij       # only for delayed-label heuristic

when target/error is available:
  g_k ← ∂loss / ∂a_out_k
  L_i ← Σ_k B_ik g_k                     # B sampled once, normalized, then fixed
  w_ij ← clip(w_ij - η L_i etilde_ij)
Actor–critic/reward-only baseline:
every timestep:
  zbar_j ← α_z zbar_j + spike_j
  e_ij   ← ψ_i zbar_j
  q_i    ← neuron-specific policy/action factor
  p_ij   ← γ_p p_ij + q_i e_ij

when reward/critic feedback is available:
  δ_R  ← r + γ V(next_state) - V(state)
  w_ij ← clip(w_ij + η δ_R p_ij)
實際 code 還應記錄 tensor shape、gradient convention、trace units、normalization 與 clipping 範圍。只要第四題沒有答案,多層 hidden network 通常還沒有真正解決跨層 credit assignment;只要第三題沒有答案,它通常只適合即時或短延遲任務;只要第二題沒有答案,它有活動記憶,卻沒有 task-directed learning。
所以真正的核心不是「大腦有沒有一個秘密版 backprop」,而是:大腦如何把局部活動、延遲結果與有方向的 teaching signal,在一個連續運作的物理系統裡接起來。
References
- Lillicrap, T. P., Santoro, A., Marris, L., Akerman, C. J., & Hinton, G. (2020). Backpropagation and the brain. Nature Reviews Neuroscience, 21, 335–346.
- Izhikevich, E. M. (2007). Solving the distal reward problem through linkage of STDP and dopamine release. PLOS Computational Biology, 3, e177.
- Bellec, G., Scherr, F., Subramoney, A., Hajek, E., Salaj, D., Legenstein, R., & Maass, W. (2020). A solution to the learning dilemma for recurrent networks of spiking neurons. Nature Communications, 11, 3625.
- Schultz, W., Dayan, P., & Montague, P. R. (1997). A neural substrate of prediction and reward. Science, 275, 1593–1599.
- Lee, R. S., Sagiv, Y., Engelhard, B., Witten, I. B., & Daw, N. D. (2024). A feature-specific prediction error model explains dopaminergic heterogeneity. Nature Neuroscience, 27, 1574–1586.
- Frémaux, N., & Gerstner, W. (2016). Neuromodulated Spike-Timing-Dependent Plasticity, and Theory of Three-Factor Learning Rules. Frontiers in Neural Circuits, 9, 85.
- Gerstner, W., Lehmann, M., Liakoni, V., Corneil, D., & Brea, J. (2018). Eligibility traces and plasticity on behavioral time scales: experimental support of neoHebbian three-factor learning rules. Frontiers in Neural Circuits, 12, 53.
- Kimpo, R. R., Rinaldi, J. M., Kim, C. K., Payne, H. L., & Raymond, J. L. (2014). Gating of neural error signals during motor learning. eLife, 3, e02076.
- Guerguiev, J., Lillicrap, T. P., & Richards, B. A. (2017). Towards deep learning with segregated dendrites. eLife, 6, e22901.
- Payeur, A., Guerguiev, J., Zenke, F., Richards, B. A., & Naud, R. (2021). Burst-dependent synaptic plasticity can coordinate learning in hierarchical circuits. Nature Neuroscience, 24, 1010–1019.
- Lillicrap, T. P., Cownden, D., Tweed, D. B., & Akerman, C. J. (2016). Random synaptic feedback weights support error backpropagation for deep learning. Nature Communications, 7, 13276.
- Whittington, J. C. R., & Bogacz, R. (2017). An approximation of the error backpropagation algorithm in a predictive coding network with local Hebbian synaptic plasticity. Neural Computation, 29, 1229–1262.
- Pang, R., Arbelaiz, J., & Pillow, J. W. (2025). Learning neural dynamics through instructive signals. bioRxiv preprint. Current model/preprint; not treated here as settled biological evidence.
- Francioni, V., Tang, V. D., Toloza, E. H. S., Ding, Z., Brown, N. J., & Harnett, M. T. (2026). Vectorized instructive signals in cortical dendrites. Nature, 652, 1254–1263.
- Eshel, N., Bukwich, M., Rao, V., Hemmelder, V., Tian, J., & Uchida, N. (2015). Arithmetic and local circuitry underlying dopamine prediction errors. Nature, 525, 243–246.
- Streng, M. L., Popa, L. S., & Ebner, T. J. (2018). Modulation of sensory prediction error in Purkinje cells during visual feedback manipulations. Nature Communications, 9, 1099.
- Larkum, M. E., Zhu, J. J., & Sakmann, B. (1999). A new cellular mechanism for coupling inputs arriving at different cortical layers. Nature, 398, 338–341.
- Shai, A. S., Anastassiou, C. A., Larkum, M. E., & Koch, C. (2015). Physiology of Layer 5 Pyramidal Neurons in Mouse Primary Visual Cortex: Coincidence Detection through Bursting. PLOS Computational Biology, 11, e1004090.