生物大腦怎麼學習:從突觸到多巴胺,把「平均」變成有方向的記憶
這篇文章只追一條主線:
若底層突觸起初都很平均、更新又帶隨機,大腦如何長出「有方向」的學習?
答案不是一個全域 loss。是:局部時間規則 + 環境統計 + 價值訊號,在幾層時間尺度上把隨機候選淘成可用電路。
1. 突觸在改什麼
興奮性突觸上,兩個角色夠用了:
- AMPA:前級一釋放麩胺酸,通道打開,Na⁺ 進來,後級去極化。日常傳訊。
- NMDA:同樣要配體,但安靜時被 Mg²⁺ 堵住。後級夠強去極化(例如回傳動作電位)才把鎂彈開,Ca²⁺ 大量流入。
教學口訣「配體 + 電位」指的就是 NMDA;嚴格說它仍是配體閘控,只是多了電壓依賴的 Mg 阻塞解除——這讓「前後級要對上」成為物理,而不是 if-else。
Ca²⁺ 進得多快、多猛,大體決定可塑性方向(簡化版):
| Ca²⁺ | 傾向 | 結果 |
|---|---|---|
| 高、陡 | LTP | 膜上 AMPA 增多,傳導變強;久了甚至棘長大 |
| 低、鈍 | LTD | AMPA 被收回,傳導變弱 |
赫布的「一起激發就連在一起」,不是現場焊一條新纜線,多半是:發育期先長很多候選突觸 → 用了的加權/保住 → 沒用的削弱或修剪。
2. STDP:毫秒級寫入因果
STDP(spike-timing-dependent plasticity)是本地、通常無監督的規則,只問一件事:前級與後級誰先放電?
- (前級先):傾向 LTP
- (後級先):傾向 LTD
- 差超過數十毫秒:當巧合,幾乎不改
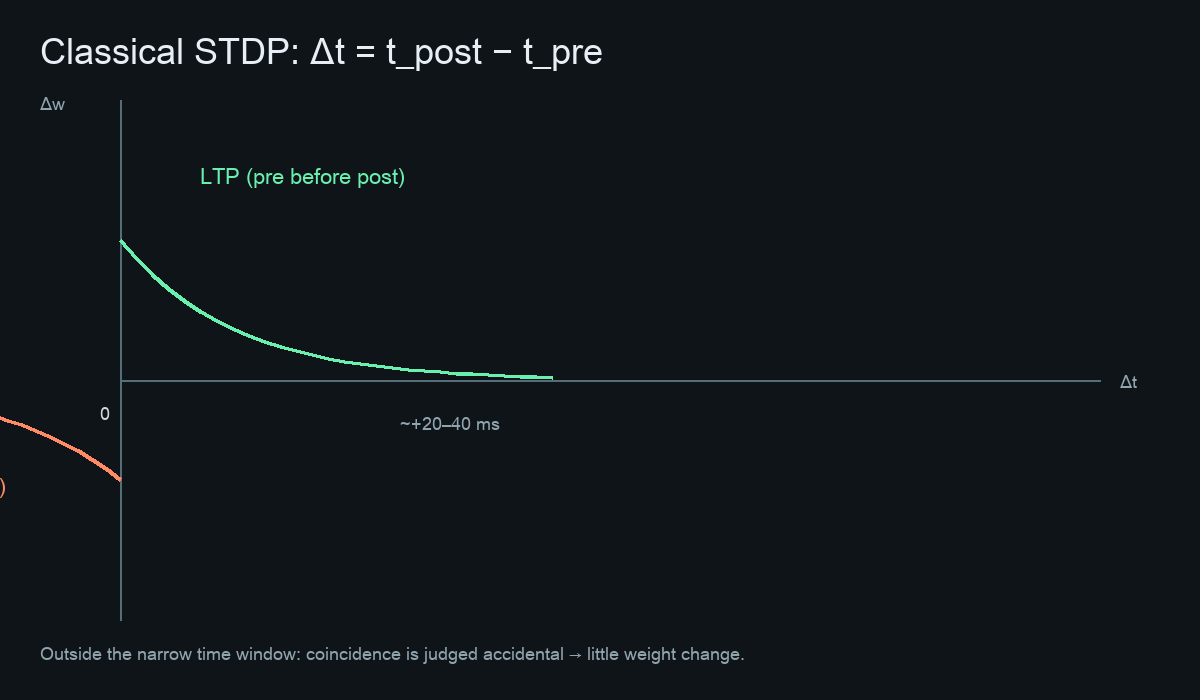
物理上:前級先放麩胺酸 → NMDA 已備好配體但 Mg 仍堵 → 幾毫秒內後級放電解 Mg → Ca 洪峰;順序反了,波形不同,偏向抑制。
一個後級接很多輸入時,誰先可靠地「幫它開火」誰就被 STDP 放大;慢半拍的被削弱。配上側向抑制,就變成 winner-take-all:環境統計在雕刻特徵,不必給 label。
局限也直白:窗口只有毫秒;純局部規則看不見「任務錯在哪裡」。遠距獎勵、深度監督,要靠後面兩節。
3. 為何一開始平均,卻學得動?
若一切完美對稱,權重確實會一起漂、學不出差異。真實大腦至少有三把刀破對稱:
- 世界不平均——同一刺激下,哪個受器先響、誰延遲幾毫秒,本來就不齊。
- 微觀雜訊——自發釋放等讓看似相同的突觸從不走同一條軌跡;正回饋把微小優勢立住。
- 橫向競爭——誰先放電誰壓鄰居,不是溫和平均分。
所以:隨機製造候補;輸入統計與競爭負責方向。不是「每一步都已知道全域梯度」。
4. 方向從哪來:尤其是個體試錯
先記住這則小故事
後面講多巴胺與 RPE,都掛在同一套情境上——經典制約實驗的簡化版(動物/猴子都行):
時間軸: [指示燈亮] …隔一小段時間… [拿到果汁]- 燈(CS):中性線索,本來不甜、不疼,只是信號。
- 果汁(US/獎勵):真正讓動物在乎的結果。
- 學習要建立的不是「果汁好吃」 alone,而是「燈來了 ≈ 等等會有果汁」。
為什麼要用這則故事?因為它把兩個問題拆開了:
- 結果本身(真的喝到果汁了沒)
- 你事先有沒有預期(看到燈時,腦是否已在賭「等下有果汁」)
多巴胺後來跟的,是兩者之差,不是果汁本身。若沒先把時序記在腦裡,後面的「前移」會像術語空降。
宏觀方向不只一個來源
微觀抖動可以是隨機;宏觀留下什麼模式,不必是。
| 來源 | 在幹嘛 |
|---|---|
| 環境統計 | 共現、共變反覆出現 → 感知特徵被 STDP 類規則加深(無監督) |
| 獎勵預測誤差(RPE) | 像上面果汁故事:報告「比預期好/差」,而不是「有糖就響」——個體試錯的主方向盤 |
| 基因/架構先驗 | 皮層怎麼分層、大概接哪裡,縮小可搜尋空間 |
| 注意/由上而下 | 拉高當下該寫入哪段電路 |
對主動行為學習而言,RPE 通常是最關鍵那一層。沒有它,系統仍能被動刻世界;有了它,探索才掛上趨利避害。
回到果汁故事:多巴胺為什麼會「前移」
重點不是「有沒有果汁時多巴胺都會響」,而是「實際結果跟預測差多少」:
-
還沒學會時
燈對動物沒意義。果汁突然出現 = 意外驚喜。
多巴胺在接到果汁的那一刻短暫爆一段(phasic 上升)。 -
學會「燈 ≈ 等下有果汁」之後
燈一亮,大腦已經預測到果汁。
多巴胺的爆點提早挪到燈亮——標記「可靠的預測線索到了」。
真正拿到果汁時,若一切如預期,不再爆(驚喜已用完,誤差≈0)。 -
學會之後卻「跳票」
燈亮了,預期有果汁,結果沒給。
在本來該拿到果汁的時間點,多巴胺會掉到低於平日基線——這就是負向 RPE,用來削弱剛才那套「燈→期待/動作」聯結。
一句話:多巴胺追的是「預測錯了多少」,不是「報酬本身」;學會之後,訊號會往時間序列更早的預測線索跑,這就叫反應「前移」。
5. 資格痕跡:把「剛才」接到「後來的果汁」
果汁故事裡還有第二個時間問題:燈亮到果汁之間,常常不是幾毫秒,而是幾百毫秒到數秒。中間若動物還做了一系列動作,經典 STDP 的毫秒窗裝不下「誰該為果汁負責」。
按鈕與掉糖、燈與延遲果汁,是同一類遠距信用問題。解法是三因素規則:
- 前後級共活(或符合該突觸的配對)→ 留下可衰減的 eligibility(資格痕跡)
- 當下不一定立刻把權重寫死
- 秒級內若來了調制訊號(多巴胺等;例如正向 RPE 的 phasic 爆發),才把仍活著的標籤轉成真正 LTP/LTD
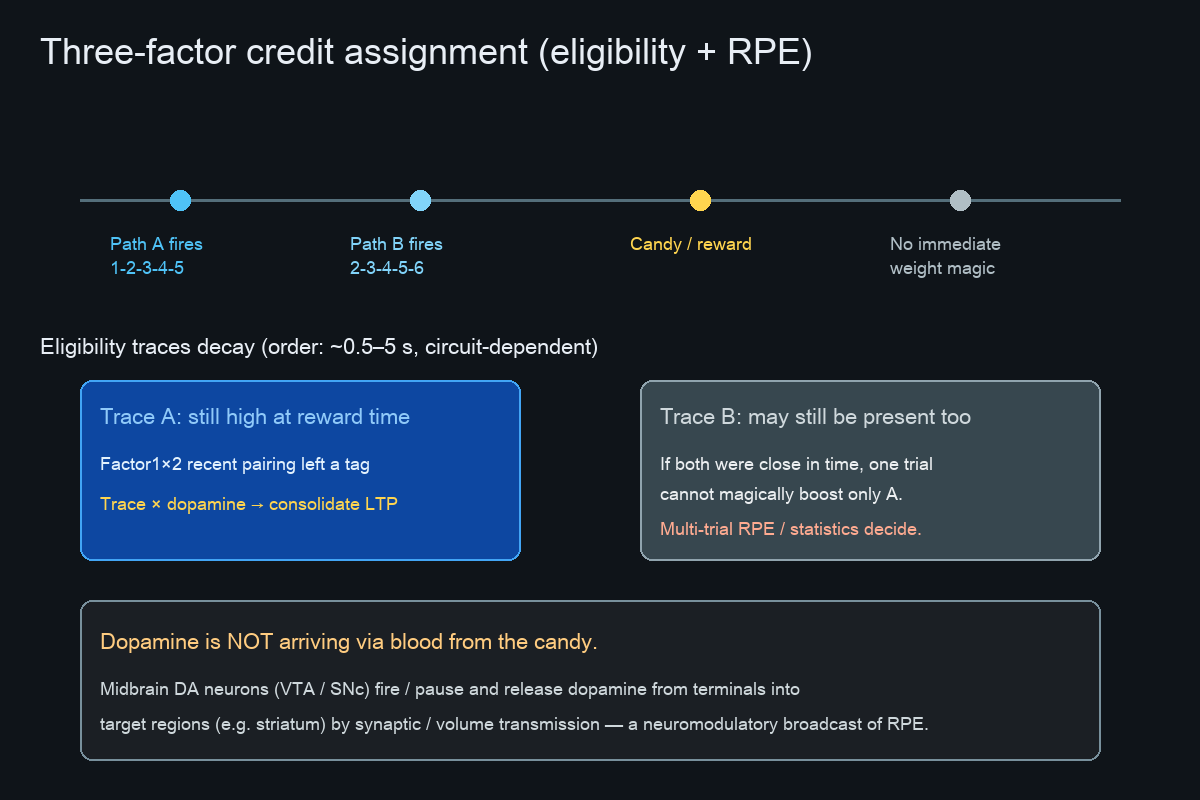
因此:不是血液把「果汁甜味」溶解後冲全腦,而是中腦多巴胺細胞改變發放,在紋狀體等靶區末梢釋放,經突觸/體積傳輸當調制廣播。
信用分配也別過乾淨。路徑 1-2-3-4-5 若剛好在獎勵前留下新鮮 traces,會被正向 RPE 加固;2-3-4-5-6 不會因為你在故事裡標了「錯」就自動免疫——它若也在同一時間窗開火,一樣可能沾到。真正拉開兩條路,靠的是跨多次試驗的預測更新:燈亮該有果汁卻沒有 → 負 RPE 削弱;穩定成功 → 正誤差縮小、反應像第 4 節那樣前移到燈。
兩點邊界:
- 許多皮層/海馬的本地 LTP 不必等多巴胺;三因素是延遲行為信用的補丁,不是唯一宇宙法則。
- 數十分鐘以上的因果,化學 traces 不夠,還要工作記憶、海馬重放等系統級機制——那已超出本文主線。
整腦大致是:
| 任務 | 主工具 |
|---|---|
| 感知特徵 | 兩因素 Hebb / STDP |
| 有後果的試錯(秒級,如燈→果汁) | 三因素 + eligibility + RPE |
| 更長延遲 | 記憶系統與重放 |
一條鏈收束
麩胺酸 → AMPA 動電位 → NMDA 在對的時刻解 Mg → Ca²⁺ 形狀決定增強/抑制 → 毫秒窗寫入 STDP,或留下 eligibility → 若牽涉延遲後果,RPE 調制在秒級固化或抹掉 → 多次試驗把政策淘穩。
深度學習用全域梯度保證信用可導;大腦用局部時間計時器 + 調制廣播 + 環境統計做同一類事的另一語言。主線到這裡就夠:不必把每個例外、每個 AI 對照表都塞進同一頁。