大腦不是在跑 PyTorch:讀〈A deep learning framework for neuroscience〉
論文題名叫 A deep learning framework for neuroscience,很容易讓人以為這是一個神經科學版的 PyTorch:下載套件、宣告模型、開始訓練。
它其實完全不是那回事。
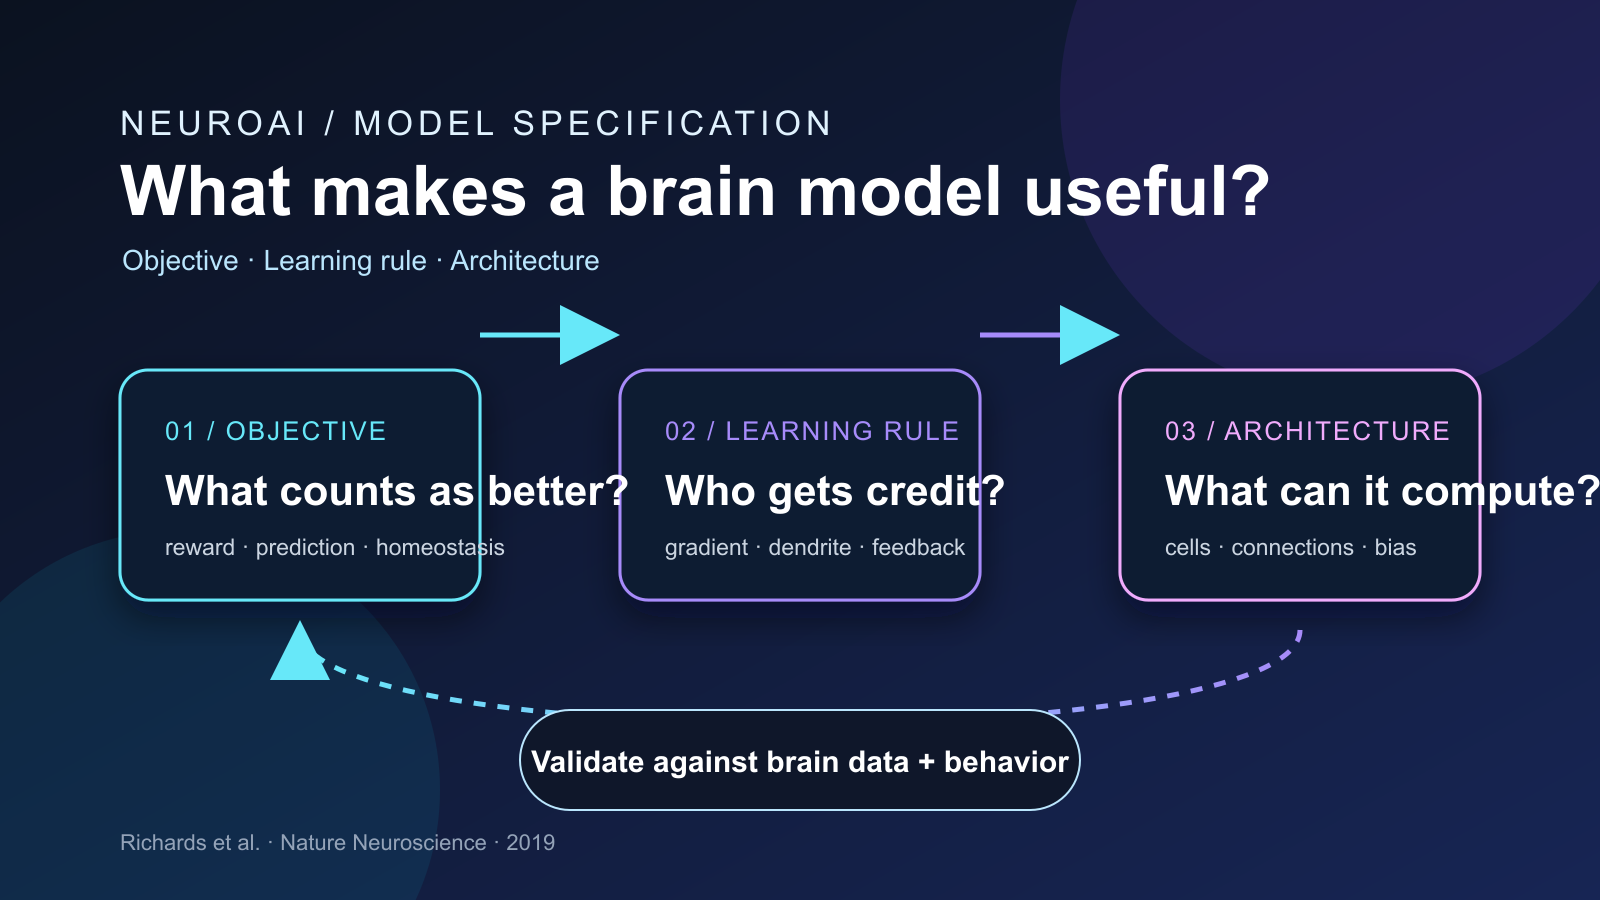
這是 Blake A. Richards、Timothy P. Lillicrap、Yoshua Bengio、Konrad Kording 等人發表在 Nature Neuroscience 的一篇 Perspective。文章沒有提出一個叫作 NeuroTorch 的 library,也沒有主張大腦直接執行標準 backpropagation。它提出的是一種研究大腦的模型規格:如果我們想理解一個大型、會學習的神經系統,至少要把三件事講清楚——它在優化什麼、突觸怎麼更新、以及神經迴路長什麼樣子。
我下載這篇 2019 年的 PDF 時,真正讓我停下來的不是標題,而是第二頁的 Figure 1:三個圓角框分別寫著 objective functions、learning rules、architectures。這張圖看起來像深度學習課本的開場,卻是在對神經科學說:不要只描述某顆神經元對某種刺激有反應,試著說明這個反應為什麼會從一組目標、更新規則與連線限制中長出來。
本文的核心判斷可以先濃縮成一句話:
這篇論文最有價值的地方,不是把深度學習的實作搬進大腦,而是要求神經科學家把「目標、學習、結構」這三個常被藏在背景裡的假設攤到桌面上,讓它們變成可比較、可干預、可反駁的模型。
先釐清:這是一套研究語法,不是軟體框架
傳統系統神經科學有一個很成功的工作方式:觀察少數神經元,為每顆神經元找一個容易描述的計算,再把它們組合成迴路。對視網膜、前庭眼反射、中央模式產生器這類小型或相對明確的系統,這個方法非常有力。
問題是,現在的實驗可以同時記錄成千上萬顆神經元,也可以觀察動物在更自然、更複雜的行為中如何學習。面對新資料,逐顆神經元寫出一句漂亮的功能描述,可能反而不是最好的壓縮方式。作者的比喻接近這樣:演化論用少數原則解釋大量物種如何出現,但不會逐字列出每一隻動物的每個細節;同樣地,大腦的高階理論也可能要解釋「為什麼會出現這些反應」,而不是假裝每個反應都能被一個短句完整概括。
因此,這篇文章不是在找一個最像大腦的 neural network。它是在提議一個拆解問題的方法,讓我們可以問:一個模型究竟靠了哪個目標、哪種更新規則、哪種架構才成功?
三個核心元件
1. Objective function:什麼叫作變得更好?
在機器學習裡,loss 或 objective function 是「系統表現好不好」的數學定義。分類模型可以最小化 cross-entropy;強化學習代理可以最大化累積 reward。重點不在於公式長什麼樣,而在於它指定了改善的方向。
把這個問題放回大腦,答案就沒有那麼直接。大腦不太可能在每張自然影像旁邊收到一個標準答案,然後最小化分類 cross-entropy。原文因此列出幾類比較有生物意義的候選目標:predictive coding 的描述長度、由 reward 加權的行動序列機率、和環境的 mutual information、empowerment,以及維持生理變數穩定的 homeostasis。
這些不是作者宣布的「大腦真正 loss function」。恰恰相反,作者明確說這篇文章提出的是 framework,不是單一 model。它真正要求的是:不要把 objective function 當成一個不用解釋的背景設定。你要告訴讀者,對哪個生物體、哪個時間尺度、哪種環境,什麼才算改善。
這也解釋了為什麼「環境」在文中很特別。作者把動物遇到的刺激與行為任務稱為 Brain Set,認為它是建模不可缺少的錨點,但沒有把環境列為第四個核心元件。我的理解是:環境負責告訴我們系統面對什麼問題,objective function 才負責把「問題」轉成可優化的標準。
2. Learning rule:哪一個突觸該得到 credit?
如果結果好轉了,我們要怎麼知道是哪幾個突觸的改變造成這個好轉?這就是 credit assignment problem。
在一個簡單模型裡,更新一個參數就看到輸出變化,問題不大;但在深層、遞迴、有延遲回饋的網路裡,一個結果可能和幾百層、幾秒鐘以前的活動都有關。標準 backpropagation 用 chain rule 把輸出端的誤差往回傳,計算每個權重應該往哪裡動。用原文 Box 1 的簡化寫法,如果目標是 ,小幅更新 帶來的變化約為:
沿著 gradient 更新,能在小步長下朝著改善最快的方向走。
但生物神經系統是否真的能做這件事?標準 backpropagation 涉及對稱的 forward / backward connections、分開的資訊傳播階段,以及需要全域誤差信號的計算方式。這些假設在工程上很有效,卻不直接等同於皮質裡的突觸可塑性。
所以作者不把「非 backprop」直接等同於「沒有學習」。Figure 3 的觀點很重要:learning rule 不一定要完美沿著 objective 的 gradient,只要它有一個與 gradient 同向的成分,長期仍可能讓目標改善。神經科學真正要回答的問題,不只是「大腦是不是使用 backprop」,而是「大腦如何在局部訊息、噪聲、延遲與生理限制下,完成足夠好的 credit assignment」。
3. Architecture:哪些計算根本做得到?
Architecture 不只是工程師最後選的 layer 數量。它包含細胞類型、連線方式、資訊能不能從哪裡流到哪裡,以及系統被預先賦予的 inductive bias。
卷積網路反覆使用同一組局部 receptive field,是一種明確的架構偏置;皮質的層級、局部迴路、長距離 feedback,也都在限制可學習的函數空間。換句話說,learning rule 再聰明,如果架構根本沒有提供所需的資訊路徑,系統就不可能學出某種行為。
這三者要一起看。objective function 決定往哪裡走,learning rule 決定怎麼走,architecture 決定路上有哪些可走的路。
從「描述神經元」改成「生成神經反應」
這套框架真正改變的,是模型在神經科學裡扮演的角色。
一個好的模型不該只是在一組刺激上把神經反應曲線擬合得漂亮。Richards 等人提出至少要同時通過三層檢查:第一,模型能否解決 Brain Set 裡的行為任務;第二,它是否符合已知的 anatomy 與 plasticity;第三,它是否能重現真實大腦的 representation,以及 representation 在學習過程中的變化。
原文 Figure 4 給了一個很具體的想像:建立一個有視覺層級、以 orientation discrimination 為目標、用 reward 驅動學習的模型。模型不只要在分類正確率上過關,還要預測哪一層的 tuning 會在學習後改變最多。若模型預測高階區域變化較大、V4 居中、V1 最小,這就可以變成實驗假說,而不是只在資料上做事後解釋。
這個差異很像 software engineering 裡的測試策略:你不是只測一個 output snapshot,而是測行為、內部狀態、邊界條件與系統在改變之後的反應。對大腦而言,這些測試就是 behavior、neural representation、anatomy、plasticity 與 perturbation。
2019 年之後:這個框架哪些地方真的有用?
Goal-driven model:先讓模型完成任務,再看它長出什麼
在這篇論文之前,Yamins 與 DiCarlo 已經整理過 goal-driven modeling:先讓 hierarchical convolutional network 完成與生物行為相關的任務,再把不同層的 representation 和視覺皮質資料比較。這個方法的強處在於,模型不是手工塞入「V4 應該長這樣」的特徵,而是讓任務目標與架構共同產生中間表徵。
這正好落在三元件框架裡:task 是 objective 的來源,HCNN 是 architecture,訓練過程是 learning rule。它也讓模型能反過來生成刺激,測試哪一類 input 會讓神經元反應最強。
但這裡已經埋下一個識別問題:如果好幾種 objective、初始化與 architecture 都能產生相近的 brain prediction,我們究竟是在找到大腦機制,還是在找到一個好用的 encoding model?
2023 年的反例:預測得準,不代表架構被辨識了
St-Yves 等人 2023 年在 Nature Communications 做了一個很適合拿來檢驗這套框架的實驗。他們用八位受試者的 7T fMRI 資料,受試者各自觀看約 9,000–10,000 張自然影像,總資料量約 213,000 個 trials。研究者把網路直接訓練成預測人類 V1–V4 的腦活動,並拿它和以 ImageNet 物件分類訓練的 AlexNet encoding model 比較。
brain-optimized GNet 在每位受試者的 V1–V4 中,對超過 68% 的 voxels 比 AlexNet 預測得好;跨受試者平均的 win percentage 約為 80%。這是「objective function 可以直接寫成預測腦資料」的一個漂亮示範,而且它在未參與訓練的自然影像與人工刺激上都做了驗證。
可是同一篇研究也給了不能忽略的限制:最佳模型在不同受試者與視覺區域,只能解釋約 37%–78% 的 explainable variance。更關鍵的是,單一路徑的 model 和為 V1、V2、V3、V4 各自訓練的 multi-branch model,預測準確率幾乎一樣。兩者都能恢復 receptive field size 隨視覺區域增加的 integration hierarchy,但只有 single-branch model 顯示 compositional hierarchy,multi-branch model 沒有。
這個結果不是把 deep learning 與神經科學的連結打掉,反而把問題問得更精準:神經資料支持某些 representation properties,卻未必唯一決定底層 architecture。再加上 fMRI 的時間解析度有限,一個 image 的 beta value 可能混合 feedforward 與 feedback activity,architecture 的因果解釋就更不能只靠一個 correlation score。
對原始論文來說,這是一個很健康的壓力測試。它支持「architecture 必須被明確討論」,但反對「只要模型預測得準,就已經找到了大腦的架構」。
最難的一關:credit assignment 還沒有被解決
這篇 2019 Perspective 最有野心、也最容易被讀成口號的部分,是它暗示生物系統可能可以用某種近似 gradient 的方式訓練深層網路。
這個方向並不是空想。Sacramento 等人在 NeurIPS 2018 提出一個包含簡化 dendritic compartments 的多層神經網路,讓 apical dendrites 的局部 prediction error 驅動突觸更新;他們展示模型可以做 regression 與 classification,並在分析上近似 error backpropagation。這類工作把「大腦如何分配 credit」轉成了具體的細胞與迴路假說。
但「可以在 benchmark 上近似 gradient」和「大腦真的使用這個機制」中間,還隔著很長一段路。Liu 等人的 NeurIPS 2022 研究特別提醒,不應只看訓練集上的 task accuracy。他們比較生物合理的 temporal credit-assignment rules 與更接近 true gradient 的方法,發現前者的 generalization 表現更差、變異也更大,並把這個差距連到 loss landscape curvature。這不是宣判生物學不可能,而是指出:一個學習規則若要作為大腦模型,必須解釋它如何泛化,而不只是如何把單一任務做對。
後續的 local learning、predictive coding、dendritic error 與 neuromodulatory methods 仍在快速發展;例如 2024 年的 Liouna 工作坊論文把 predictive coding 與 masked image modeling 組成局部、無監督的學習規則,並報告在低計算量情境下的 transfer 結果。不過這類 benchmark 結果應該被解讀為「這個演算法方向值得研究」,而不是「這就是腦內的 learning rule」。
這篇論文最該被保留的三個習慣
讀完原文與後續研究,我會留下三個可以直接套用在 NeuroAI 論文閱讀上的問題:
- 模型到底在優化什麼? 是行為正確率、預測未來、節省描述長度、維持 homeostasis,還是事後選出來最能解釋資料的 objective?
- 錯誤如何抵達正確的突觸? 如果是 local rule,遠距離 credit、時間延遲、neuromodulation 與 feedback 分別扮演什麼角色?
- 哪些證據能排除替代模型? 除了 neural similarity,是否還有跨任務 generalization、時間動力學、解剖連線、學習期間的變化,以及可操作的 perturbation prediction?
2024 年 Nau、Schmid、Kaplan、Baker 與 Kravitz 等人提出以 task demands 與 generalization 為核心的 cognitive neuroscience framework,主張要同時改變刺激、指令與行為,並在多任務與多模態資料上明確測試 generalization。這和 Richards 等人 2019 年的方向是相通的:模型不能只在一個 task、一種資料型態、一次性表現上勝出。
我對這篇論文的評價
它最成功的地方,是把一個容易變成哲學口號的問題,拆成三個工程師可以檢查的欄位:objective、learning rule、architecture。這個拆法能讓神經科學與 AI 互相借用工具,也能讓實驗設計從「這個 representation 看起來像不像」往「如果這個機制是真的,下一個干預應該造成什麼變化」前進。
它沒有解決、也不可能靠一篇 Perspective 解決的,是三個更硬的問題:大腦同時優化多個互相衝突的目標;生物學上的 temporal credit assignment 仍然沒有共識;而相同的 neural data fit 可能由不同架構和 readout 產生。這些不是文章的失敗,而是讀者不應該替它補上的結論。
所以,今天再讀這篇論文,我不會把它當成「深度學習已經解釋了大腦」的宣言。我會把它當成一份 model-review checklist:每看到一個號稱 brain-like 的模型,就追問它的目標、更新規則、結構、資料外推,以及能否被實驗推翻。
這比找一個最像大腦的網路更務實,也更接近科學。
References
- Richards, B. A. et al. “A deep learning framework for neuroscience.” Nature Neuroscience 22, 1761–1770 (2019). DOI · PMC full text · author PDF
- Yamins, D. L. K. & DiCarlo, J. J. “Using goal-driven deep learning models to understand sensory cortex.” Nature Neuroscience 19, 356–365 (2016). DOI
- St-Yves, G. et al. “Brain-optimized deep neural network models of human visual areas learn non-hierarchical representations.” Nature Communications 14, 3329 (2023). DOI
- Sacramento, J., Costa, R. P., Bengio, Y. & Senn, W. “Dendritic cortical microcircuits approximate the backpropagation algorithm.” NeurIPS 2018, 8735–8746. Paper
- Liu, Y. H. et al. “Beyond accuracy: generalization properties of bio-plausible temporal credit assignment rules.” NeurIPS 2022. Paper · OpenReview
- Rezk, F. et al. “Liouna: Biologically Plausible Learning for Efficient Pre-Training of Transferrable Deep Models.” WANT@ICML 2024 workshop. OpenReview
- Nau, M. et al. “Centering cognitive neuroscience on task demands and generalization.” Nature Neuroscience 27, 1656–1667 (2024). DOI