Janelia 的兩個大賭注:解腦與 AI-in-the-Loop 會互相驗證嗎?
Janelia 同時押注兩件事:理解脊椎動物的大腦如何產生複雜行為,以及建立一個能讓 AI 參與下一輪實驗的科學閉環。多數「AI 進入科學」的新聞,想像中的畫面是一位科學家坐在螢幕前問模型問題;Janelia 想處理的是更大的系統。
它不是在實驗室旁邊放一個聊天機器人,而是把 AI 放進「提出問題、設計實驗、收集資料、建立模型、產生下一個實驗」的循環裡。AI 產出的假說與預測,必須在下一輪實驗中被驗證或推翻。
HHMI 旗下的 Janelia Research Campus 最近宣布兩個 big bets:第一個,解出脊椎動物的大腦如何產生複雜行為;第二個,建立 AI-in-the-Loop Discovery,一種讓科學家專業與 AI 分析能力持續互相驅動的生物學研究方式。HHMI 的原始公告把這兩件事放在同一個敘事裡,這個綁定本身就是重點。
官方把兩者列為並列目標。我的解讀是:腦研究可能提供最嚴格的試煉場(proving ground),而 AI-in-the-Loop 的可移植性仍是待驗證的假設。這不是一個已經端到端運作、並證明能持續產生新實驗的閉環系統;目前公開資料主要描述的是研究方向與組織設計。
兩個賭注到底在押什麼?
第一個賭注不是單純預測動物下一步會做什麼。Janelia 所說的「機制性理解」(mechanistic understanding),是要把行為一路連回神經迴路、細胞和分子:哪些神經元參與了計算?它們如何互相連接?訊號如何在時間中流動?最後又怎麼變成一隻活著的動物在真實環境裡移動、學習、決策?
這個尺度很容易被新聞標題壓扁。從分子到神經元、從神經元到神經迴路,再到整隻動物,不是把幾個資料集接起來就完成。每一層都有不同的觀測方式、時間尺度與因果問題。Janelia 早期的 Mechanistic Cognitive Neuroscience 計畫,就已經把目標寫成理解動物如何使用內在模型,在不確定環境中做出彈性行為,並由實驗神經科學家、理論家與工具開發者共同處理技術和概念障礙。Janelia 的研究區域說明
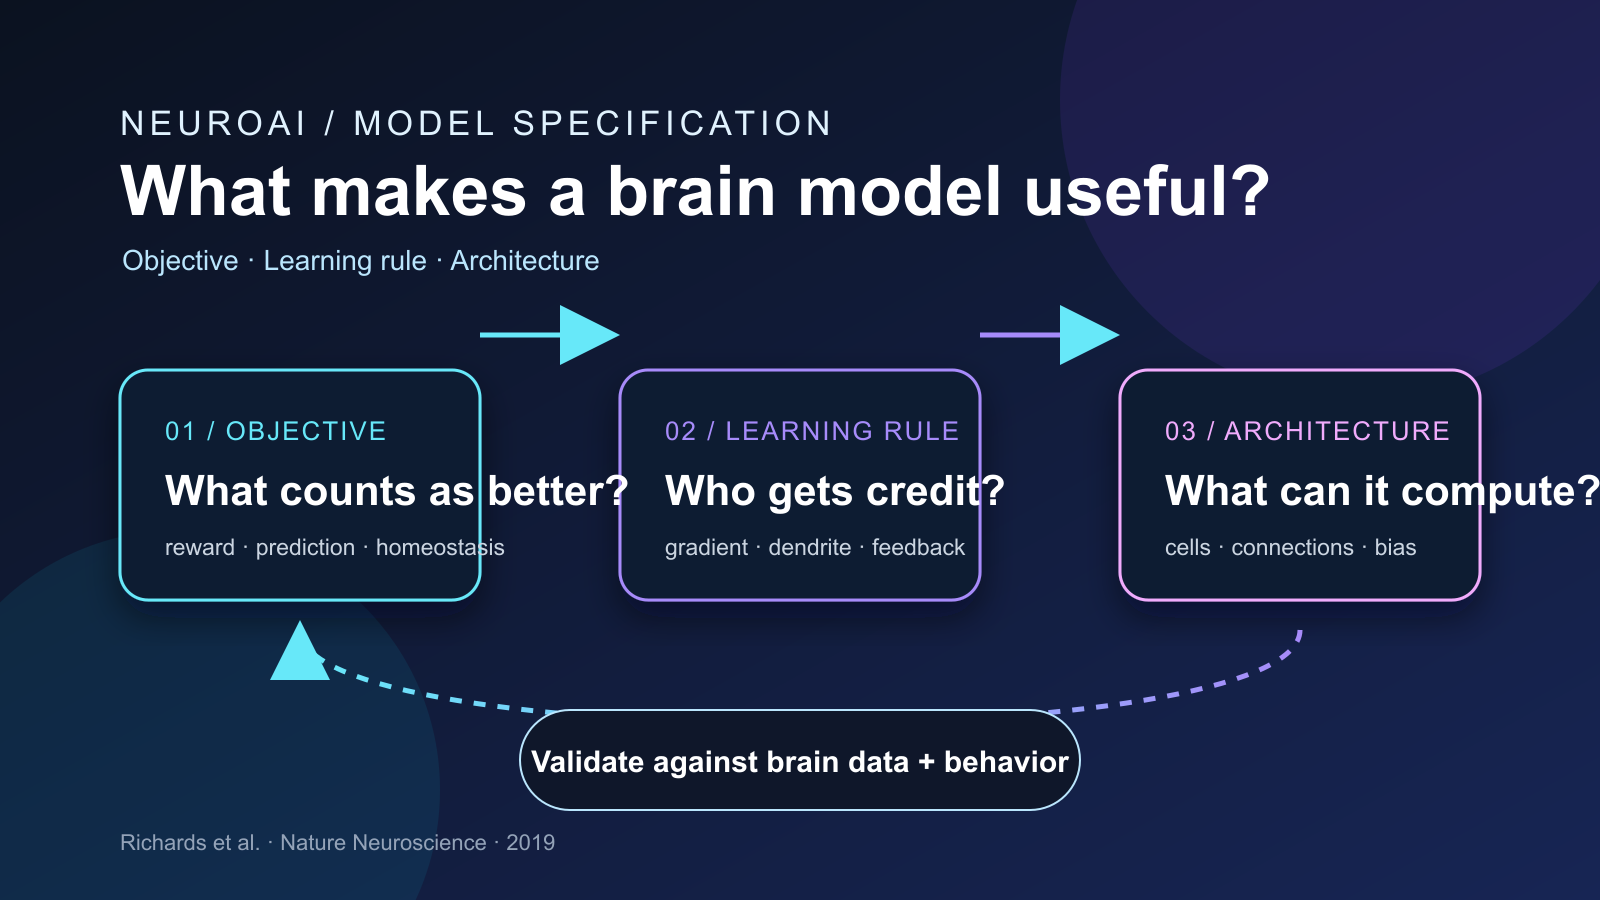
第二個賭注是 AI-in-the-Loop Discovery。HHMI 對它的描述不是「用 AI 讀論文」,而是把 AI 放到實驗設計、自動化流程、適合 AI 使用的資料(AI-ready data)收集,以及從資料推斷一般原理的模型裡。HHMI 的 AI@HHMI 計畫在 2024 年宣布,將在 10 年內投入 5 億美元;這筆投資涵蓋 Janelia 與 HHMI 關聯實驗室,公開資料沒有說明其中多少直接用於這兩個賭注。Janelia 則把方向寫得更直接:讓理論、計算與實驗設計形成閉環。AI at Janelia
可以把它畫成一個比「科學家問 AI 問題」更接近真實工作的循環:
flowchart TD
  Q[研究問題] --> E[研究者設計實驗與測量]
  E --> D[資料+實驗條件+失敗紀錄]
  D --> M[AI 與機制模型]
  M --> P[可推翻的預測/下一個干預]
  P --> E
  M --> T[研究者判讀與新問題]
  T --> Q
AI 不會自行完成科學閉環;研究者仍要選擇問題、設計干預並判讀結果。
這個閉環的關鍵不是箭頭很多,而是每一圈都要留下能被下一圈使用的東西:可重現的測量、明確的假設、可推翻的預測,以及知道自己不知道什麼的模型。
為什麼要從腦開始?因為它是最難的整合測試
腦科學常見的陷阱,是把「看見相關性」誤認成「理解機制」。我們可以看到一群神經元在動物做某件事時一起活化,卻還不知道這些神經元是不是必要、它們如何和其他細胞互動,或同一個行為換個環境後是否仍由相同機制產生。
Janelia 自己的研究已經展示了一個重要的中間步驟。2024 年,Janelia 與德國圖賓根大學的團隊把果蠅視覺系統一個部分、以週期方式平鋪的神經連結體模型,和「這個神經迴路應該完成動作偵測」的任務目標放在一起,再用深度學習最佳化模型中的未知參數。這個模型涵蓋單眼中央視野的 64 種神經元類型;模型中的神經元和突觸對應到真實腦中的結構,最後預測了這些神經元類型的活動,並和 26 項既有實驗研究的測量結果一致。Janelia 的研究說明;原始論文發表於 Nature。Lappalainen et al.
Janelia 的新聞稿還提到,這個模型產生了超過 450 頁的預測,包括過去不知道可能參與動作偵測的細胞。這不是「模型說答案是什麼」;比較接近一台假說產生器:如果這個神經迴路的連接與任務目標都是真的,那麼下一個活體實驗應該會看到什麼?
但這個例子也提醒我們不要過度樂觀。這項研究處理的是果蠅視覺系統的動作偵測,不是複雜行為;模型也採用簡化的神經元與化學突觸動力學,沒有完整納入電突觸、神經調節與膠質細胞等因素。AI 最佳化的是一個受神經連結體與任務目標約束的模型參數;這些參數能產生可驗證預測,卻不等於已直接量出或唯一辨識出真實生物機制。果蠅視覺系統的成功,不等於脊椎動物的複雜行為已經可解。原論文也指出,神經連接和任務本身並不能唯一決定一個迴路的機制;靜態連結體與活腦動態計算之間仍有落差。
因此,如果這個方向要算成功,我會要求它逐步把四種證據放進可以互相約束的系統:行為、神經活動、結構連接,以及細胞和分子層級的變化。這不是 Janelia 已經宣布完成的架構,而是我認為能把「機制性理解」和一般預測區分開來的成功標準。也正因為如此,腦研究可能成為 AI-in-the-Loop 的高難度壓力測試。
第二個賭注其實是在重做「實驗室作業系統」
Janelia 對 AI 的想像,和把大型語言模型接到一個聊天介面上有本質差異。它要組合的是幾種原本就分散的能力:
- 用機器視覺(machine vision)從大規模影像中擷取可用訊號;
- 用計算成像(computational imaging)和感測器測量原本看不到的生物過程;
- 用理論模型把資料濃縮成可以解釋、也可以反駁的原理;
- 讓模型輸出的預測反過來決定下一個實驗要怎麼做。
這個安排很像工程團隊裡真正可靠的回饋系統(feedback system):不是把模型接在流程末端產生一份報告,而是讓模型的輸出改變下一次輸入。差別在於,科學裡的輸入不是 API request,而可能是新的行為設計、一次昂貴的成像、一次基因或神經迴路的干預。
我在整理 Janelia 的資料時,最值得注意的不是「AI」這個字,而是它反覆強調資料與測量本身。Janelia 的 AI 團隊把建立高品質資料集、影像分析、感測器、理論框架與實驗設計放在同一頁。這揭示一個常被忽略的瓶頸:世界沒有被測量成模型能可靠使用的形式。
這也是 HHMI 願意把 AI@HHMI 拉到 10 年、5 億美元規模的原因之一。這不是只替 Janelia 的兩個賭注編列一筆專款;若只買幾個模型 API,這筆跨 Janelia 與 HHMI 關聯實驗室的投資會很快變成一堆短期 demo。要做 AI-in-the-Loop,必須同時投資科學家、AI 工程師、機器人、資料科學、儀器與共享基礎設施,還要把成果交還給其他實驗室使用。
Janelia 的制度,本身就是技術的一部分
Janelia 能押這種長期、高風險的題目,不只是因為有好的研究者。它的制度設計也在降低研究摩擦:內部 funding、不要求科學家為每個想法申請外部 grant、小型研究群組、跨領域的自組織合作,以及鼓勵風險承擔。Our Model甚至直接把「People Not Projects」當成精神。
它的歷史頁面則寫得更具體:Janelia 在 2004 年的規劃中就想像過需要約 1,000 person-year 的大型跨領域計畫,2008 年開始形成 Project Teams。這種規模不適合用一般學術制度的短期產出邏輯管理,因為工具、資料和團隊默契往往要先累積,成果才會出現。Janelia History
換句話說,Janelia 的研究模式不是這個計畫的背景介紹,而是計畫能否成立的基礎設施。如果每個實驗室都只對自己的論文、grant 或短期 KPI 負責,AI-in-the-Loop 很容易被切成幾個互不相通的 demo。要讓閉環真的接上,需要有人能跨過實驗室邊界,修工具、定資料標準、承認模型不準,然後把下一輪實驗做完。
但這也留下可移植性問題:Janelia 的制度優勢依賴少數機構才負擔得起的長期資金、專職支援團隊與基礎設施。即使閉環在 Janelia 成功,也不代表一般實驗室能以相同方式複製。
兩個賭注為什麼必須綁在一起?
把這兩件事拆開看,就會變成兩個很熟悉的故事:一個是「神經科學想解開腦」,另一個是「AI 可以加速科學」。綁在一起後,才出現一個更具體的策略:
第一個賭注提供最難、也最能檢驗閉環的問題。只要模型只能在乾淨的資料集上分類,卻不能跨越行為、神經活動與結構,這個計畫就可能很快看見它的極限。
第二個賭注則提供讓第一個問題不至於變成一次性專案的方法。從某個腦區得到的工具、資料格式、模型與實驗策略,如果能被其他 HHMI 實驗室採用,這個計畫才不只是「Janelia 解了一個腦」,而是留下新的研究基礎設施。
這是我的推論,不是 HHMI 公告中的原句;另一種合理讀法是,HHMI 只是把兩個互相支撐的目標並列提出。若採用我的讀法,腦是試煉場,AI-in-the-Loop 才是可擴散的成果形式,而這個層級關係仍待未來十年的實作驗證。
這個計畫最可能在哪裡失敗?
第一,預測可能會跑得比理解快。模型可以準確重現已知神經活動,卻仍然沒有告訴我們哪些干預會改變行為。對「機制性理解」這個目標來說,這個差距不能靠更多漂亮的視覺化掩蓋。
第二,果蠅到脊椎動物的遷移不是單純的擴展。資料量變大只是最表面的問題;更難的是行為情境、神經迴路、動物個體差異,以及如何在活體中同時觀測和干預。Janelia 已經有果蠅神經連結體的技術先例,但那是可信的起點,不是成功保證。
第三,回饋系統可能把科學帶向「容易測量的問題」。只要系統的回饋訊號偏好高品質影像、漂亮的預測或快速的實驗,沒有被量化的現象就可能逐漸失去資源。系統會把被獎勵的指標越做越好,卻不一定讓科學理解更深。
第四,適合 AI 使用的資料不是把 CSV 清乾淨就好。對生物學來說,校準、實驗條件、失敗紀錄、負結果、干預歷史與樣本選擇,都可能決定模型能不能從相關性走向可測試的機制。如果這些中繼資料(metadata)沒有進入資料閉環,模型看見的世界會比實驗室以為的更整齊,也更虛假。
最後是開放性。HHMI 已經說明 AI@HHMI 的目標是透過共享工具與結果,讓這種方法不只留在 HHMI。如果成果最後只能在 Janelia 的內部流程裡運作,第二個賭注就會退化成一個昂貴的自動化計畫;真正的成功標準,應該是外部生物學家能否拿走其中一部分,放進自己的系統,並做出原本做不到的實驗。
如果這個方向成立,其他團隊該觀察什麼?
第一,先畫出自己的研究閉環,再問「要不要加一個 AI agent」:哪個地方目前最慢?哪個輸出能改變下一個實驗?如果模型只在流程末端寫摘要,它沒有真正進入閉環。
第二,把測量能力當成模型能力的一部分。Janelia 把成像、感測器、資料註記、理論和計算放在同一個研究方向裡;如果這個方向成立,這比單獨追逐更大的模型更接近科學問題的實際瓶頸。
第三,長期賭注需要長期組織。高風險研究不是把 deadline 拿掉就會自動發生;它需要內部 funding、跨學科團隊、共享工具,以及允許研究者在模型失敗後還有機會做下一輪實驗的制度。
未來十年,我會用四個判準看這個計畫是否真的成功:模型預測是否被活體干預與行為結果驗證;解釋是否超過單純的神經活動預測;工具與資料是否能在 Janelia 之外被重現;以及閉環是否真的協助研究者提出更好的下一個實驗,而不只是更快地分析資料。這些判準比模型基準測試更難,也更接近科學真正的進步。
參考資料
- HHMI:Janelia’s Two Big Bets: Decoding the Brain and Reinventing How Science is Done
- HHMI:HHMI Invests $500 Million in AI-Driven Life Sciences Research
- Janelia:AI at Janelia
- Janelia:Our Model
- Janelia:History
- Janelia:Mechanistic Cognitive Neuroscience
- Janelia:Researchers combine the power of AI and the connectome to predict brain cell activity
- Lappalainen et al., “Connectome-constrained networks predict neural activity across the fly visual system,” Nature