海馬的認知地圖不是地圖:從 Successor Representation 讀懂 place cells 與 grid cells
如果把海馬迴想成一張地圖,最容易得到的直覺是:每個 place cell(位置細胞)對應一個位置,細胞亮起來就是「我現在在這裡」。這個直覺不算錯,卻漏掉了論文真正有趣的地方。
2014 年 NIPS 論文〈Design Principles of the Hippocampal Cognitive Map〉提出的核心主張是:海馬迴的空間表示,可能不是單純記錄座標,而是把「從這裡出發,接下來可能會到哪裡」編碼進去。這張圖不是地圖 App 的截圖,比較像一個會隨著你的走法、障礙物和目標改變的未來路線快取。
這個轉換很重要。它把 place field(位置場,細胞在空間中的活動區域)、獎勵敏感性、方向偏好、障礙物造成的扭曲,以及 grid cell(網格細胞)的週期性圖樣,放進同一個計算框架裡。論文沒有證明海馬迴真的照著一個矩陣運算;它提出的是一個很有力量的設計假說:如果神經系統要用地圖來導航與學習獎勵,那麼一張預測性的地圖比一張靜態幾何圖更實用。
從「我在哪裡」改成「我接下來會去哪裡」
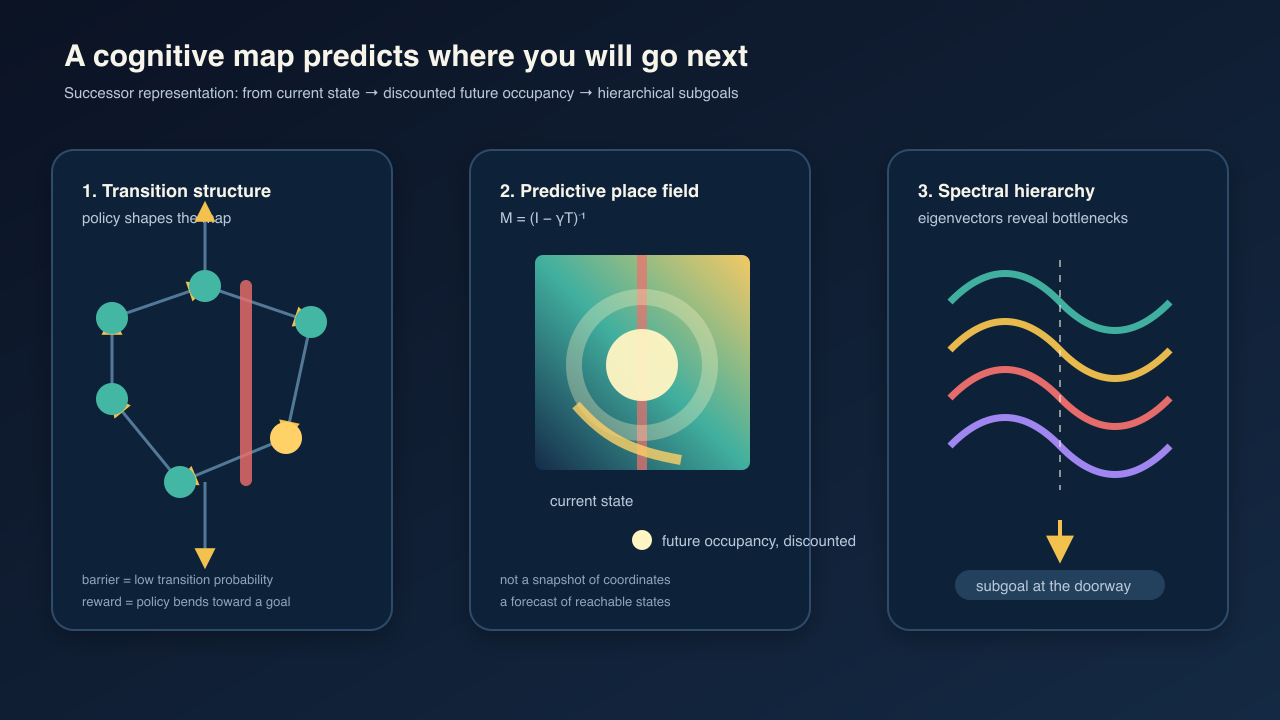
先把問題寫成強化學習(Reinforcement Learning, RL)。代理人位於狀態 s,可以採取行動,依照目前的策略 π 移動到下一個狀態。令 T(s, s′) 表示在這個策略下,從 s 到 s′ 的轉移機率。
Successor Representation(SR,後繼表示)不直接儲存每個位置的價值,而是儲存一個狀態會帶來哪些未來狀態。形式上可以寫成:
M = (I − γT)⁻¹
其中 γ 是時間折扣,M(s, s′) 是從 s 出發後,未來造訪 s′ 的折扣期望次數。於是價值函數可以寫成 V = M R:先學好「未來會經過什麼」,之後只要把新的獎勵向量 R 乘上去,就能快速估計價值。
這像是把台北的街區資訊拆成兩層:一層是道路之間怎麼連,另一層是每條路現在有什麼好處。咖啡店換成書店時,第一層不用重畫;如果捷運施工導致整條路不能走,第一層才需要更新。SR 的效率與限制,正好都在這裡。
因此,一個 place cell 的 firing field 不必被解讀成「這顆細胞代表一個幾何點」。在 SR 模型裡,它更像是「哪些起點會預測我所代表的未來位置」。物理上相鄰的兩點,如果被牆隔開、走法完全不同,神經表示可以很不相似;物理距離稍遠但通往同一組未來狀態的兩點,反而可以比較相似。
為什麼障礙物會改變 place field?
原始論文的模擬把這個直覺變成了幾個具體預測。
第一,障礙物會讓跨越它的轉移機率接近零,所以 SR place field 不會像歐幾里得距離那樣平滑地穿過牆。這與實驗上 place field 在障礙物附近發生扭曲的現象相容。
第二,如果動物在一條線性軌道上被訓練成偏好由左往右走,預測性的 firing field 會沿著相反方向偏斜:因為從某些位置出發,未來更可能造訪「前方」的狀態。這裡的方向性不是額外貼在地圖上的箭頭,而是 transition policy 本身的一部分。
第三,目標會改變策略。靠近獎勵的位置,動物更常朝著目標移動,於是與這些位置相關的預測會擴張或提高 firing rate。論文用這個機制解釋 place cells 為何會在 rewarded location 附近聚集,而不必假設獎勵直接修改一張純座標地圖。
我讀到這裡時,最容易寫錯的一句話是「reward 讓 place field 移動」。比較準確的說法是:reward 改變了動物的 transition policy,而 policy 改變了 SR;place field 的變化是透過這條路徑產生的。這個差別也說明了模型的代價:地圖會依照行為策略而變,不是一個永遠固定的世界幾何。
這張圖還能解釋什麼?
論文沒有停在神經活動的形狀,而是把 SR 拿去做行為模擬。
在有半穿透性邊界的環境裡,跨過邊界的轉移越困難,兩側狀態在 SR 空間中的距離就越大。這提供一個對「邊界兩側的距離被高估」的計算解釋:主觀距離不一定是尺量出來的,而可能反映走到彼此的難易度。作者也很小心地註明,這個海馬迴與距離估計之間的直接神經連結當時尚未建立。
在 contextual fear conditioning 的 pre-exposure effect 裡,動物先熟悉場景,再接受一次電擊,通常會更快學會害怕這個場景。SR 的解釋是,預先探索已經建立了整個場景的預測表示;之後某個位置發生厭惡事件,相關資訊可以沿著預測結構快速傳播。這和「海馬迴只是把一個場景綁成單一記憶物件」不同,重點在於它先學到了場景內部的可達關係。
Grid cells 為什麼會出現在這個故事裡?
SR 是一個很大的矩陣,但神經系統不一定要把每個元素原封不動存下來。論文接著問:能不能把 SR 做 eigendecomposition,也就是找出一組更低維、可組合的基底?
答案和 spectral graph theory(譜圖論)有關。把環境看成圖,位置是節點,移動是邊;圖的 eigenvectors 會在連通性強的區域內平滑,在瓶頸處快速變化。多房間環境裡,第二個特徵向量,也就是 Fiedler vector,可以在門口把空間分成兩半。反覆切割,就能得到房間到子房間的階層。
在開放空間與 hairpin maze 的模擬中,高頻 eigenvectors 會出現類似 grid cells 的週期性圖樣。這讓作者提出一個野心較大的猜想:entorhinal cortex(內嗅皮質)的 grid cells 可能不只是在做幾何定位,也可能是 predictive map 的多尺度基底,幫助系統壓縮空間、找出 bottleneck(瓶頸),並為 hierarchical reinforcement learning 提供 subgoals。
這一段要讀得精確:「像 grid cells」不是「已證明 grid cells 在做 SR 的特徵分解」。 2014 論文提出的是計算角色,還不是電路層級的觀察。它也指出,普通的 Fourier analysis 假設空間跨越邊界仍然平滑;對有牆、有門、有多房間拓撲的環境,graph spectral basis 更符合「能不能走到」的結構。
後來的證據支持到哪裡?
這個想法後來被擴寫成 2017 年 Nature Neuroscience 的〈The hippocampus as a predictive map〉。作者把論點說得更清楚:place cell activity 受到 predictive coding、reward sensitivity 與 policy dependence 影響,因此不應只視為純空間表示;grid cells 則可能提供 predictive representation 的低維基底。
同一年,Momennejad 等人的〈The successor representation in human reinforcement learning〉測試了 SR 位於 model-free 與 model-based RL 之間的特徵。SR 會把未來狀態的預測先存起來,因此面對 reward 改變時可以靈活更新,但面對 transition structure 改變時不會像完整 model-based 系統那樣從頭推演。兩個人類行為研究觀察到這種不對稱,支持人類選擇中存在 SR-like 的計算成分。這仍然是行為簽名,不是直接量到「海馬迴裡有一個 SR 矩陣」。
2022 年的 Fang 等人研究則補上更具體的機制問題:前面的 SR 主要停在 algorithmic level,還沒說明生物神經元怎麼算。作者用具備 local learning rules 與 adaptive learning rate 的 recurrent network,展示一個在穩態下能計算 SR 的神經模型,並拿模擬活動與 tufted titmice 的資料比較。它讓假說更接近可實作的 circuit,但仍是模型,不是海馬迴電路已被確認的 blueprint。
再往後,研究者開始處理「一張固定地圖不夠用」的問題。Geerts 等人在 2023 年提出 probabilistic SR,讓系統在不確定與 context switch 下維持多個 task-specific SR,並依照預測準確度推斷此刻該用哪一張。另一篇 2023 年人類研究〈Hippocampal spatio-predictive cognitive maps adaptively guide reward generalization〉則發現,spatial map 與 predictive map 可以共同影響 reward generalization,而且兩者的權重會隨著回饋證據調整。
這條研究線的方向很一致:不是把認知地圖從「幾何」改成「預測」後就結束,而是繼續追問預測依賴哪個 policy、哪個 context,以及系統如何在地圖之間切換。
限制:SR 是設計原理,不是海馬迴的身分證
這個模型最強的地方也是最容易被誤讀的地方。它可以用一個簡潔的數學物件,統一解釋很多 place-field 現象;但同一種神經活動通常可能由不只一種目標函數、學習規則或電路產生。
此外,SR 對 policy 很敏感。動物換了路線、目標或可用行動,T 就可能改變;如果沒有多 context、uncertainty 或快速更新機制,一張 SR 不會是所有情境通用的地圖。它也只是在 model-free 與 model-based 之間取得折衷,並非自動擁有完整世界模型。
最後,predictive map 不是海馬迴功能的全部。episodic memory、replay、關係抽象,以及海馬迴與皮質的分工,都還需要其他機制。2022 年的模型回顧〈How to build a cognitive map〉把這個分歧講得很清楚:不同模型可以都承認海馬迴表徵具有預測性,卻對「海馬迴到底計算什麼、皮質負責什麼」給出不同答案。
讀這篇論文時,請先問四個問題
- 狀態空間是什麼? 是老鼠在房間裡的位置,還是更抽象的事件、概念與情境?
- T 來自哪個 policy? 如果走法與目標改變,模型的表示是否也應該改變?
- 改變的是 reward 還是 transition? SR 對兩者的反應不同,這是它最重要的可檢驗預測之一。
- 證據支持的是計算,還是生物機制? 模型能重現 place/grid-like pattern,只能先支持計算假說;要談機制,還需要局部學習規則、時序動態與真實神經資料。
我的結論很簡單:海馬迴認知地圖最值得保留的設計原理,不是「一個神經元代表一個座標」,而是「把當下狀態表示成對未來的可達性預測」。這個表示同時服務記憶、導航與獎勵學習,也自然帶出它的限制:只要世界的走法、目標或情境變了,地圖就必須重新估計。
References
- Stachenfeld, K. L., Botvinick, M. M., & Gershman, S. J. (2014). Design Principles of the Hippocampal Cognitive Map. Advances in Neural Information Processing Systems 27.
- Stachenfeld, K. L., Botvinick, M., & Gershman, S. (2017). The hippocampus as a predictive map. Nature Neuroscience, 20, 1643–1653.
- Dayan, P. (1993). Improving generalization for temporal difference learning: The successor representation. Neural Computation, 5, 613–624.
- Momennejad, I. et al. (2017). The successor representation in human reinforcement learning. Nature Human Behaviour, 1, 680–692.
- Fang, C. et al. (2022). Neural learning rules for generating flexible predictions and computing the successor representation. eLife.
- Geerts, J. P. et al. (2023). A probabilistic successor representation for context-dependent learning. Psychological Review.
- Garvert, M. M. et al. (2023). Hippocampal spatio-predictive cognitive maps adaptively guide reward generalization. Nature Neuroscience, 26, 615–626.
- Whittington, J. C. R. et al. (2022). How to build a cognitive map: insights from models of the hippocampal formation.