當你的部落格被 AI 爬蟲日復一日地抓取,這些內容被拿去訓練模型、回答使用者問題,卻沒有一分錢流回你手中。這個不對稱的局面,Cloudflare 正試圖用一個塵封多年的 HTTP 狀態碼來翻轉:402 Payment Required。
現況:AI 爬蟲正在掏空開放網路
根據 Cloudflare 的數據,AI 爬蟲每天向其網路發送超過 500 億次請求,占所有 HTML 請求流量的 4.2%。而 Imperva 的報告更顯示,2024 年 bot 流量首次超過人類流量,達到全網流量的 51%。
但最令人驚訝的不是流量規模,而是 AI 公司「拿走」與「回饋」之間的巨大落差。
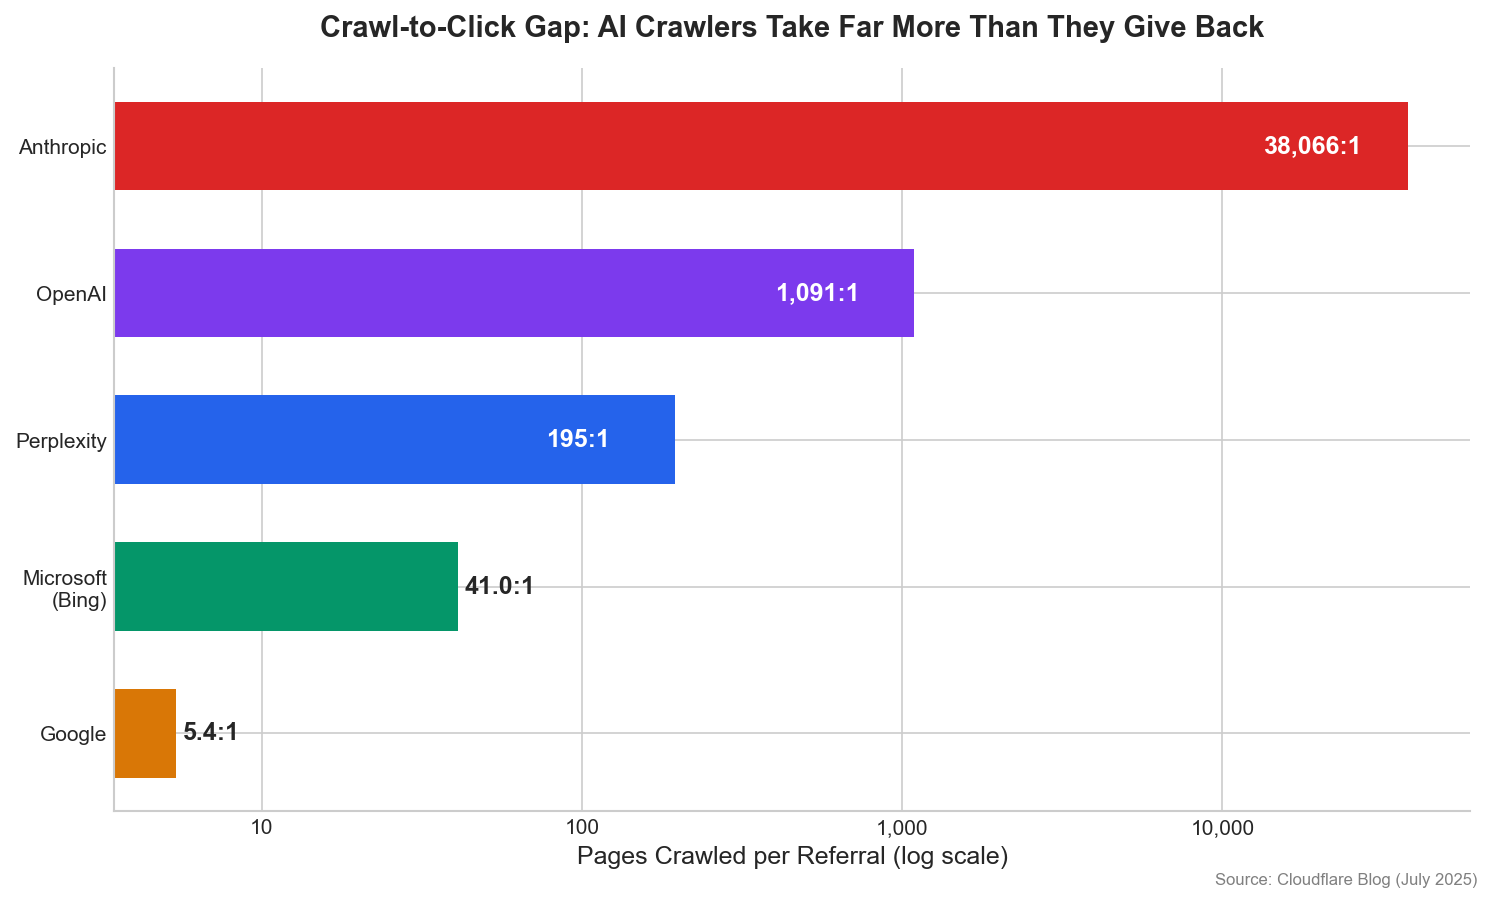
Cloudflare 的數據揭示了一個驚人的不對稱:Anthropic 每爬取 38,066 個頁面,才會回送 1 個人類訪客;OpenAI 是 1,091:1;即便是相對友善的 Perplexity 也是 195:1。相比之下,Google 的比例是 5.4:1 — 每爬 5 個頁面就送回一個訪客。
這正是 Cloudflare CEO Matthew Prince 所說的:「如果網路要在 AI 時代存活,我們需要給出版者應有的控制權,建立一個對所有人都有效的新經濟模型。」
AI 爬蟲生態系的權力版圖
過去一年,AI 爬蟲的競爭格局發生了劇烈變化。
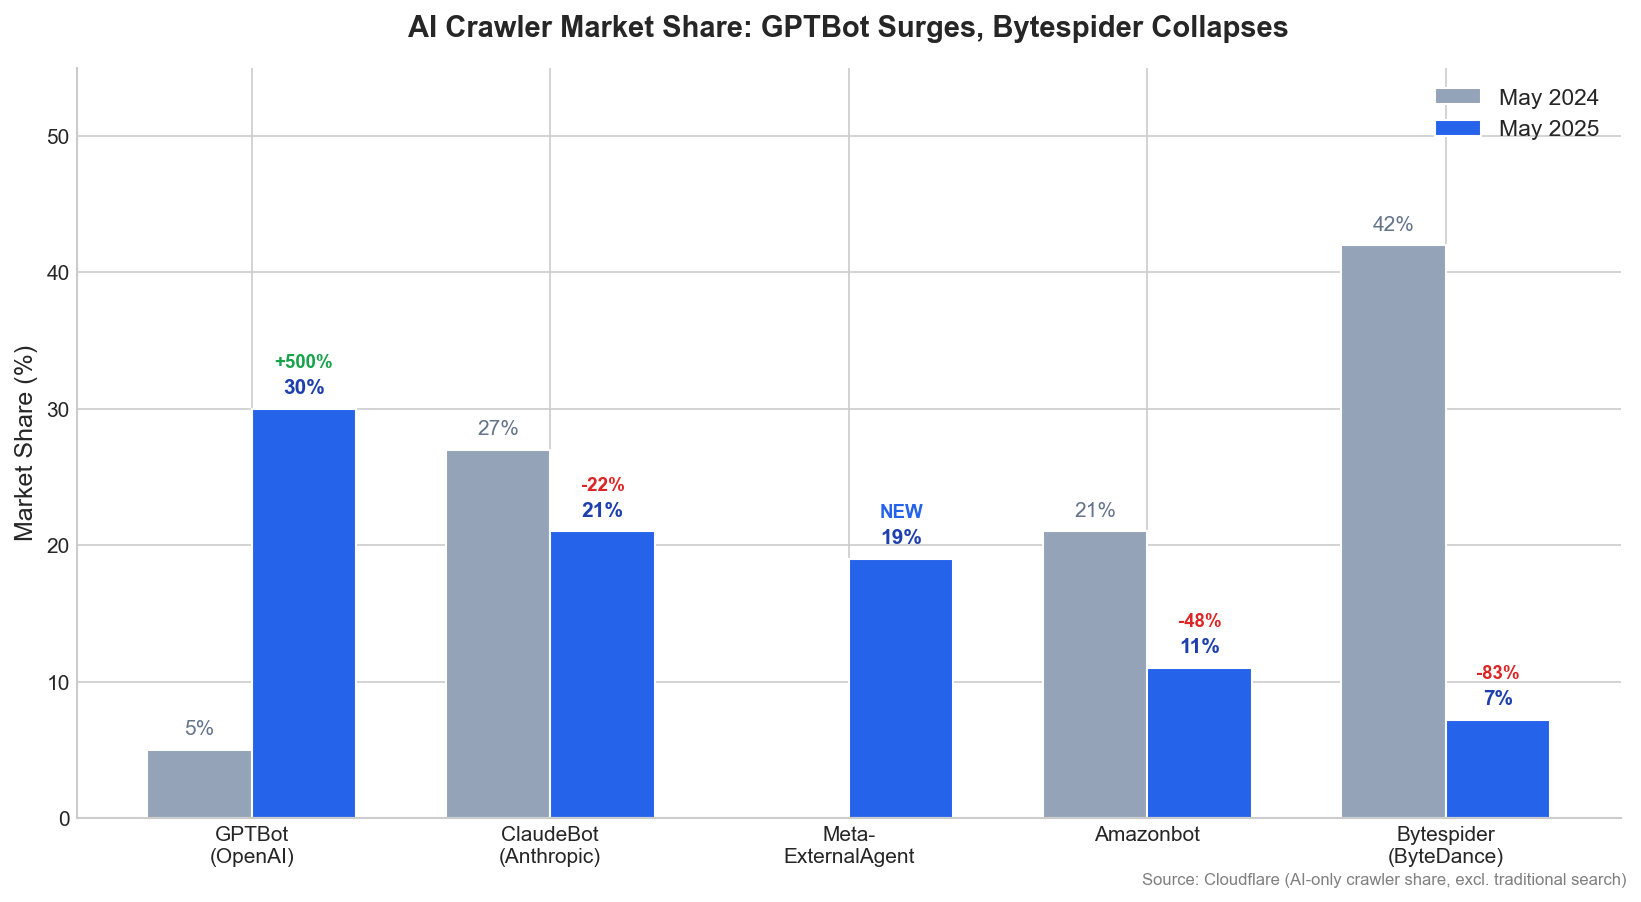
最顯著的變化是 ByteDance 的 Bytespider 從 42% 暴跌到 7%(下降 83%),而 OpenAI 的 GPTBot 從 5% 飆升到 30%(增長 500%)。Meta 的 ExternalAgent 從零迅速竄升到 19%。這反映了各大 AI 公司對訓練資料的激烈競爭。
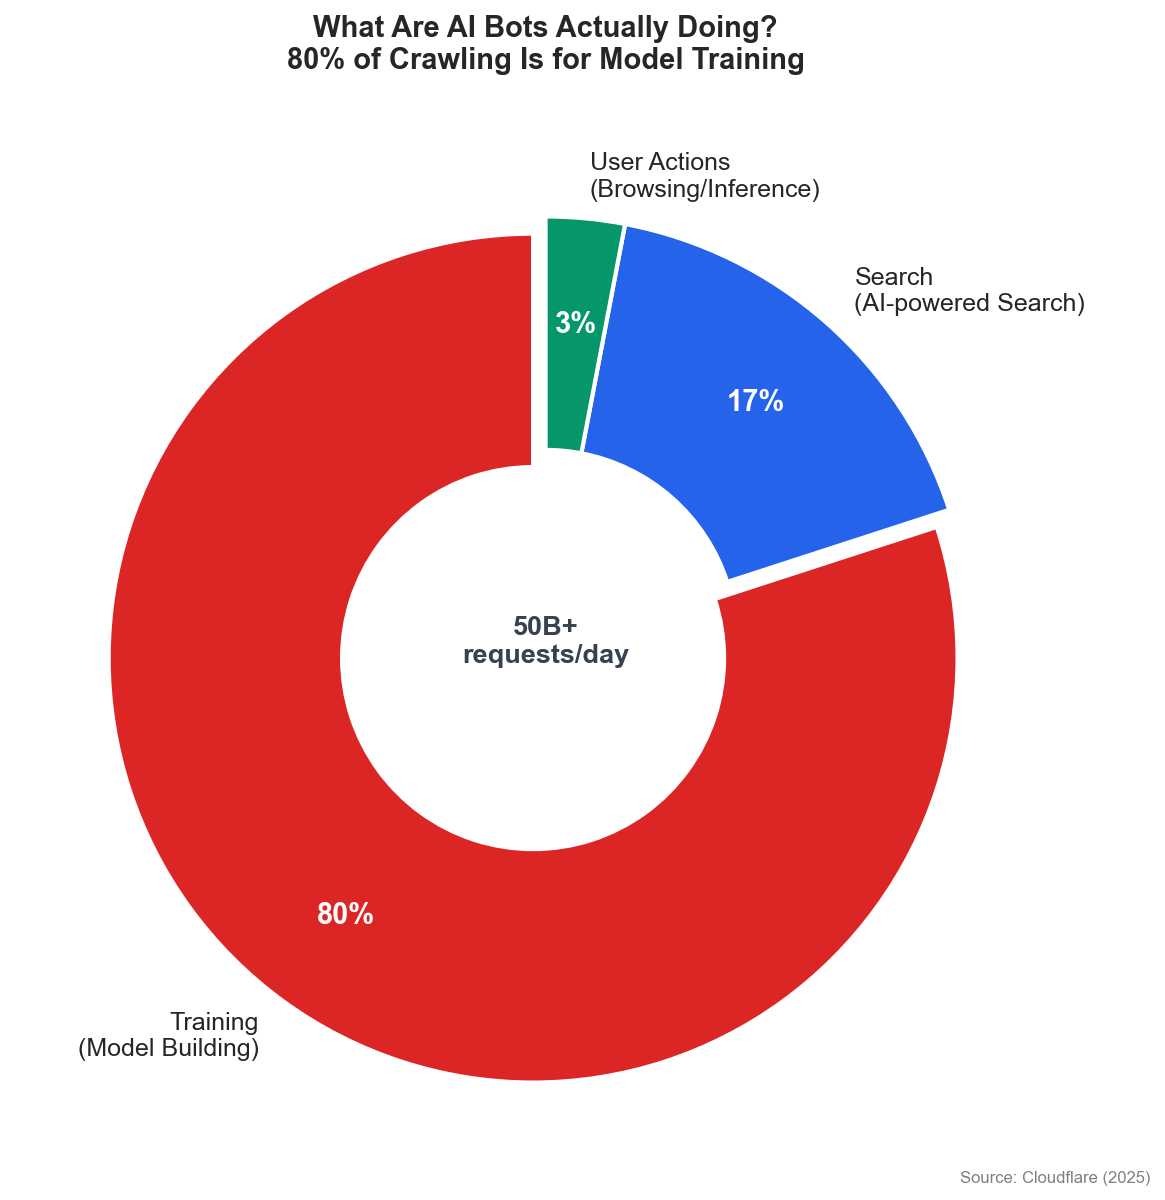
更值得注意的是,80% 的 AI 爬蟲流量是用於模型訓練,只有 17% 用於 AI 搜尋,3% 用於使用者互動。換言之,絕大部分爬蟲不是在幫你的讀者找到你的內容 — 它們是在把你的內容搬走。
什麼是 AI Crawl Control?
Cloudflare 的 AI Crawl Control(前身為 AI Audit)於 2025 年 8 月 28 日正式 GA,提供三個選項讓網站擁有者控制每個 AI 爬蟲的存取:
- Allow(允許):免費存取
- Charge(收費):透過 Pay Per Crawl 收取費用
- Block(封鎖):拒絕存取
一個重大的政策轉變:自 2025 年 7 月 1 日(Cloudflare 稱之為「Content Independence Day」)起,所有新加入 Cloudflare 的域名都預設封鎖 AI 爬蟲。網站擁有者必須主動選擇允許。考慮到 Cloudflare 驅動了全球 20% 的網站,這是一個影響深遠的決定。
自該政策實施以來,Cloudflare 已封鎖了超過 4,160 億次 AI 爬蟲請求。超過 100 萬名客戶選擇封鎖 AI 爬蟲。
Pay Per Crawl:HTTP 402 的復活
HTTP 402 Payment Required 這個狀態碼在 1999 年被定義後,一直「保留供未來使用」,沉睡了超過 25 年。Cloudflare 的 Pay Per Crawl 終於賦予了它實際意義。
技術協議流程
Pay Per Crawl 支援兩種付款流程:
Discovery-First(被動發現)流程:
1. 爬蟲 → GET /article (帶簽名 headers)
2. 伺服器 → HTTP 402 + crawler-price: USD 0.01
3. 爬蟲 → GET /article + crawler-exact-price: USD 0.01
4. 伺服器 → HTTP 200 + crawler-charged: USD 0.01 + 內容
Intent-First(主動出價)流程:
1. 爬蟲 → GET /article + crawler-max-price: USD 0.05
2. 伺服器 → HTTP 200 + crawler-charged: USD 0.01 + 內容
   (若價格超出預算則回傳 402)
自訂 HTTP Headers
| Header | 方向 | 範例 | 用途 |
|---|---|---|---|
crawler-price | 回應 (402) | USD 0.01 | 伺服器宣告價格 |
crawler-max-price | 請求 | USD 0.05 | 爬蟲宣告最高出價 |
crawler-exact-price | 請求 | USD 0.01 | 爬蟲同意確切價格 |
crawler-charged | 回應 (200) | USD 0.01 | 確認扣款金額 |
crawler-error | 回應 (402) | InvalidCrawlerExactPrice | 錯誤代碼 |
Web Bot Auth:Ed25519 密碼學身份驗證
為了防止爬蟲偽裝身份,Pay Per Crawl 使用了基於 RFC 9421 HTTP Message Signatures 的驗證機制。每個爬蟲必須:
- 生成 Ed25519 金鑰對
- 將公鑰以 JWK 格式發布在
/.well-known/http-message-signatures-directory - 每次請求都附帶三個 headers:
Signature-Agent(指向金鑰目錄)、Signature-Input(簽名元資料)、Signature(Ed25519 簽名)
付款 headers(crawler-exact-price 或 crawler-max-price)必須包含在簽名輸入中,以防止篡改和重放攻擊。
值得一提的是,Cloudflare 已將這些技術提交為 IETF 草案(draft-meunier-web-bot-auth-architecture),並且 Google 也是共同作者 — 這暗示了業界對標準化的共識。
與 x402 的關聯
Cloudflare 還與 Coinbase 共同推出了 x402 協議,使用穩定幣(USDC)進行 HTTP 402 支付。雖然目前 Pay Per Crawl 使用傳統計費(信用卡,每日結算),但未來 x402 可能成為替代支付管道,實現去中心化的即時微支付。
實際能賺多少?
這是最現實的問題。讓我們用數據來回答。
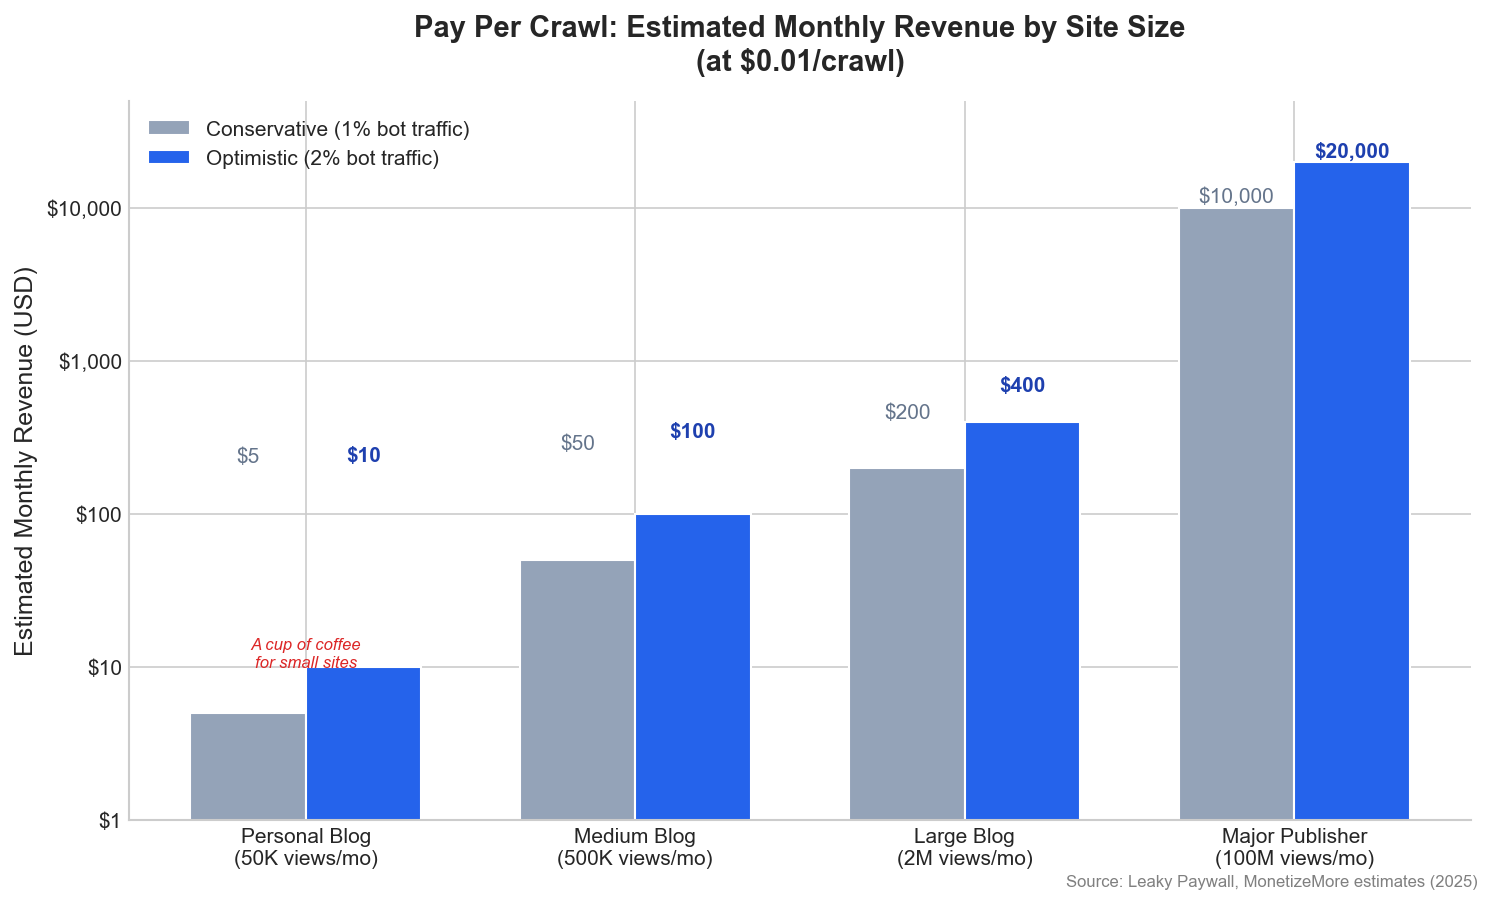
以每次爬取 $0.01 美元計算(目前最低價),假設 1-2% 的流量來自 AI 爬蟲:
| 網站規模 | 月瀏覽量 | AI 爬蟲訪問 | 月收入估算 |
|---|---|---|---|
| 個人部落格 | 5 萬 | 500-1,000 次 | 10 |
| 中型部落格 | 50 萬 | 5K-10K 次 | 100 |
| 大型部落格 | 200 萬 | 2 萬-4 萬次 | 400 |
| 大型出版商 | 1 億 | 100 萬-200 萬次 | 20K |
現實是殘酷的:對大多數個人部落格來說,Pay Per Crawl 的收入大概就是一杯咖啡錢。但對於大型出版商,這是一筆不可忽視的收入。
更重要的是:很多爬蟲收到 402 後可能直接停止爬取而不是付費。Stack Overflow 啟用 Pay Per Crawl 後就觀察到這個現象。
大局觀:AI 內容授權市場
要理解 Pay Per Crawl 的意義,需要看更大的圖景。
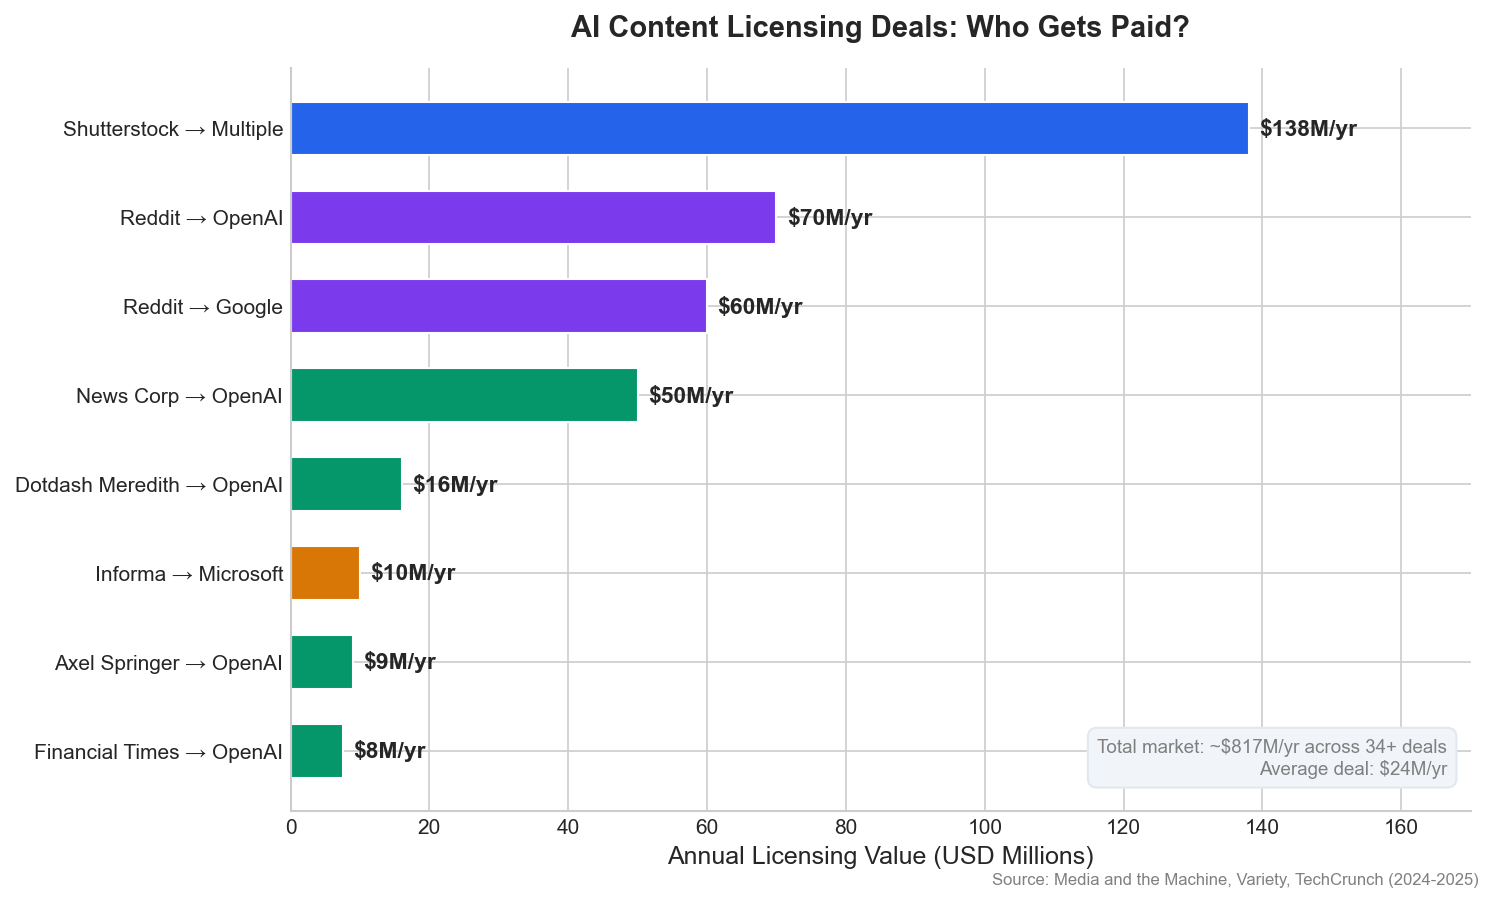
目前 AI 公司與出版商之間已達成的內容授權交易總額約 29.2 億美元,2024 年年度授權支出約 8.17 億美元。OpenAI 佔據 52.9% 的交易量。
幾個代表性交易:
- News Corp + OpenAI:5 年 2.5 億美元(~5,000 萬/年)
- Reddit + Google:6,000 萬美元/年
- Reddit + OpenAI:~7,000 萬美元/年
- Shutterstock + 多家 AI 公司:2023 年收入 1.04 億美元
但這些交易只屬於頂級出版商。一般的部落格作者、小型出版者根本沒有談判的籌碼。Pay Per Crawl 的真正價值在於民主化 — 讓任何掛上 Cloudflare 的網站都能參與這個經濟體系,而不是只有手握法律團隊的大出版商。
同時,出版商面臨的壓力正在加劇。Google 搜尋導流在 2025 年全球下降了 27%,新聞網站的自然流量從每月 23 億降到 17 億 — 損失了 6 億次訪問。AI Overview 的點擊率只有 8%,而傳統搜尋結果是 15%。
主要 AI 爬蟲一覽
| 爬蟲名稱 | 營運商 | 目的 | 遵守 robots.txt? |
|---|---|---|---|
| GPTBot | OpenAI | 訓練 | 是 |
| ChatGPT-User | OpenAI | 推論/瀏覽 | 是 |
| ClaudeBot | Anthropic | 訓練 | 是 |
| Meta-ExternalAgent | Meta | 訓練 (Llama) | 延遲遵守 |
| Bytespider | ByteDance | 訓練 | 否(抓取但忽略) |
| PerplexityBot | Perplexity | AI 搜尋 | 是 |
| CCBot | Common Crawl | 開放語料庫 | 是 |
| Amazonbot | Amazon | AI 服務 | 是 |
| Applebot-Extended | Apple | Apple Intelligence | 是 |
| DeepSeekBot | DeepSeek | 訓練 | 否(無法識別 UA) |
值得注意的是,約 5.7% 的 AI 爬蟲使用偽裝的 User Agent,而新一代瀏覽器型 AI agent(如 ChatGPT Atlas/Operator、Google Mariner)使用標準 Chrome UA,幾乎無法透過傳統方法偵測。這讓 Web Bot Auth 的密碼學身份驗證變得更加重要。
如何設定(實作指南)
步驟 1:將域名加入 Cloudflare
- 在 Cloudflare Dashboard 點擊「Add Site」
- 輸入你的域名
- 選擇 Free 方案(AI Crawl Control 在免費方案即可使用)
- 在 AI crawlers 設定中選擇「Do not block (allow crawlers)」
- 到你的域名註冊商更換 Nameserver 為 Cloudflare 提供的 NS 記錄
步驟 2:查看 AI 爬蟲數據
域名啟用後,進入 AI Crawl Control 面板:
- Crawlers 頁籤:查看哪些 AI 爬蟲在爬取你的網站
- Analytics 頁籤:查看爬取量趨勢
步驟 3:申請 Pay Per Crawl Beta
- 前往 Cloudflare 的 Pay Per Crawl 申請頁面
- 核准後,在 AI Crawl Control > Settings 啟用 Pay Per Crawl
- 設定每次爬取的價格(最低 $0.01 USD)
- 連接 Stripe 帳戶以接收付款
- 在 Crawlers 頁籤將想收費的爬蟲設為「Charge」
免費路徑
以下路徑永遠不會被收費:
/robots.txt/sitemap.xml/security.txt/.well-known/security.txt/crawlers.json
現實建議
對個人部落格(如本站):
- 先開啟 AI Crawl Control(免費)觀察數據
- 了解有多少 AI 爬蟲在訪問你的網站
- 暫時不急著申請 Pay Per Crawl — 小站收益有限
- 考慮策略性地允許 AI 搜尋爬蟲(Perplexity、OAI-SearchBot)以獲得引流
- 封鎖純訓練型爬蟲(除非你願意讓它們免費使用)
對中大型出版商:
- 立即申請 Pay Per Crawl Beta
- 同時探索直接授權交易(收益更高)
- 使用 AI Crawl Control 的數據作為談判籌碼
結語
Pay Per Crawl 本身不會讓部落格作者致富,但它代表了一個重要的範式轉移:網路上的內容不再是理所當然的免費資源。HTTP 402 沉睡 25 年後被喚醒,或許正是 AI 時代給開放網路帶來的最大結構性變化之一。
Cloudflare 每天已經發送超過 10 億次 402 回應。不管你的網站大小,至少先打開 AI Crawl Control 看看數據 — 你可能會驚訝於有多少 AI 爬蟲正在悄悄地讀取你的內容。
參考資料:
- Cloudflare: Introducing Pay Per Crawl
- Cloudflare: Introducing AI Crawl Control
- Cloudflare: The Crawl-to-Click Gap
- Cloudflare: From Googlebot to GPTBot
- Stack Overflow: Why We Launched Pay-Per-Crawl
- Imperva Bad Bot Report 2025
- Cloudflare Pay Per Crawl Documentation
- Media and the Machine: AI Content Licensing Deals